渲染的概念
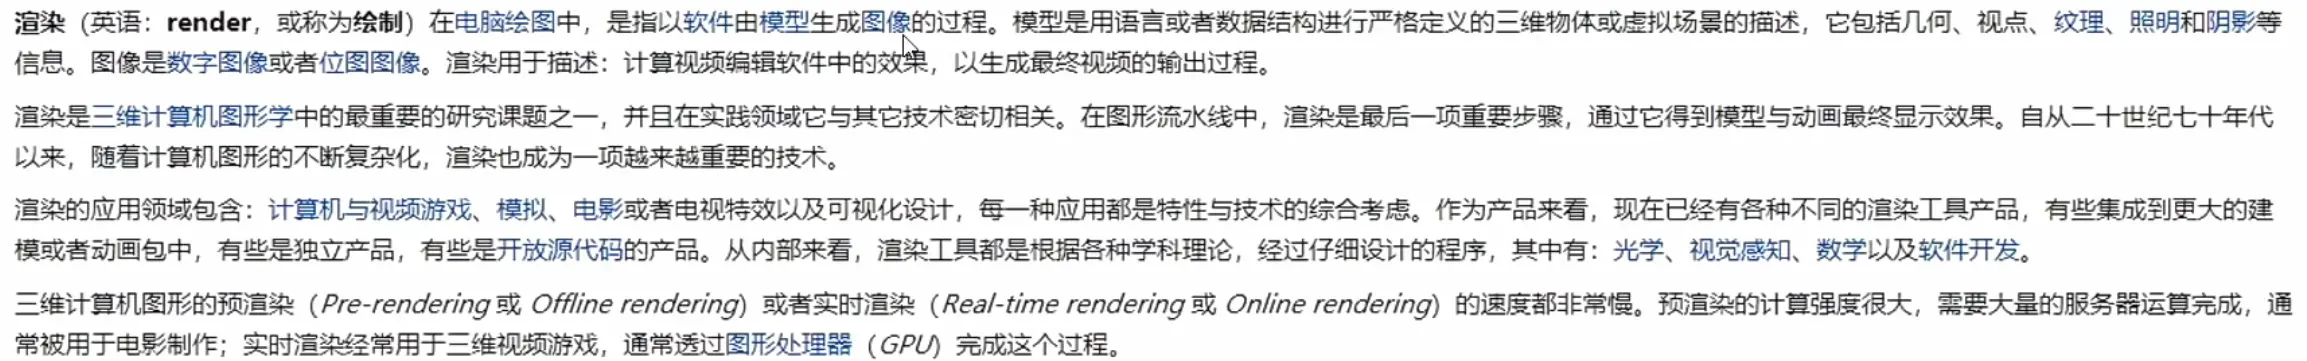
分成离线渲染和实时渲染,离线渲染多用于影视行业进行大规模的计算,实时渲染多用于游戏行业,需要优化手段加速渲染流程。
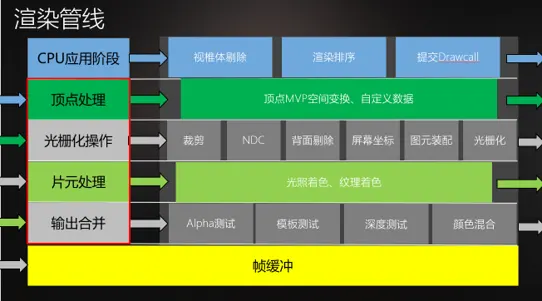
渲染管线
以unity渲染管线为例
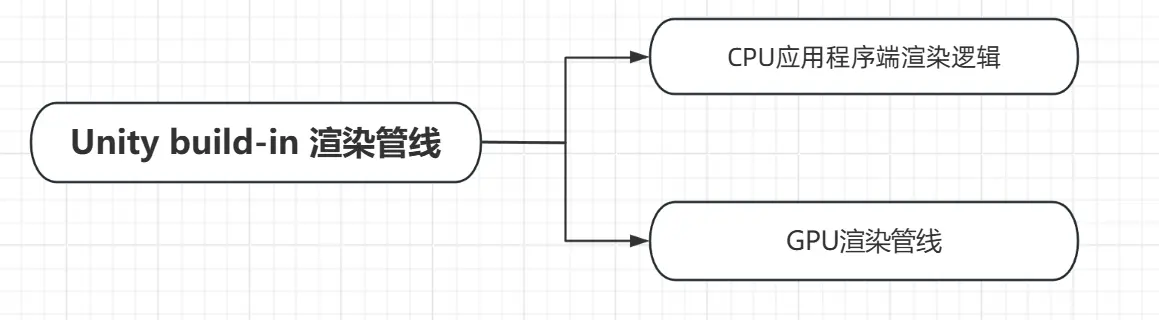
我们一般指的渲染管线是GPU端的渲染管线,但是CPU端的渲染管线也同样很重要。
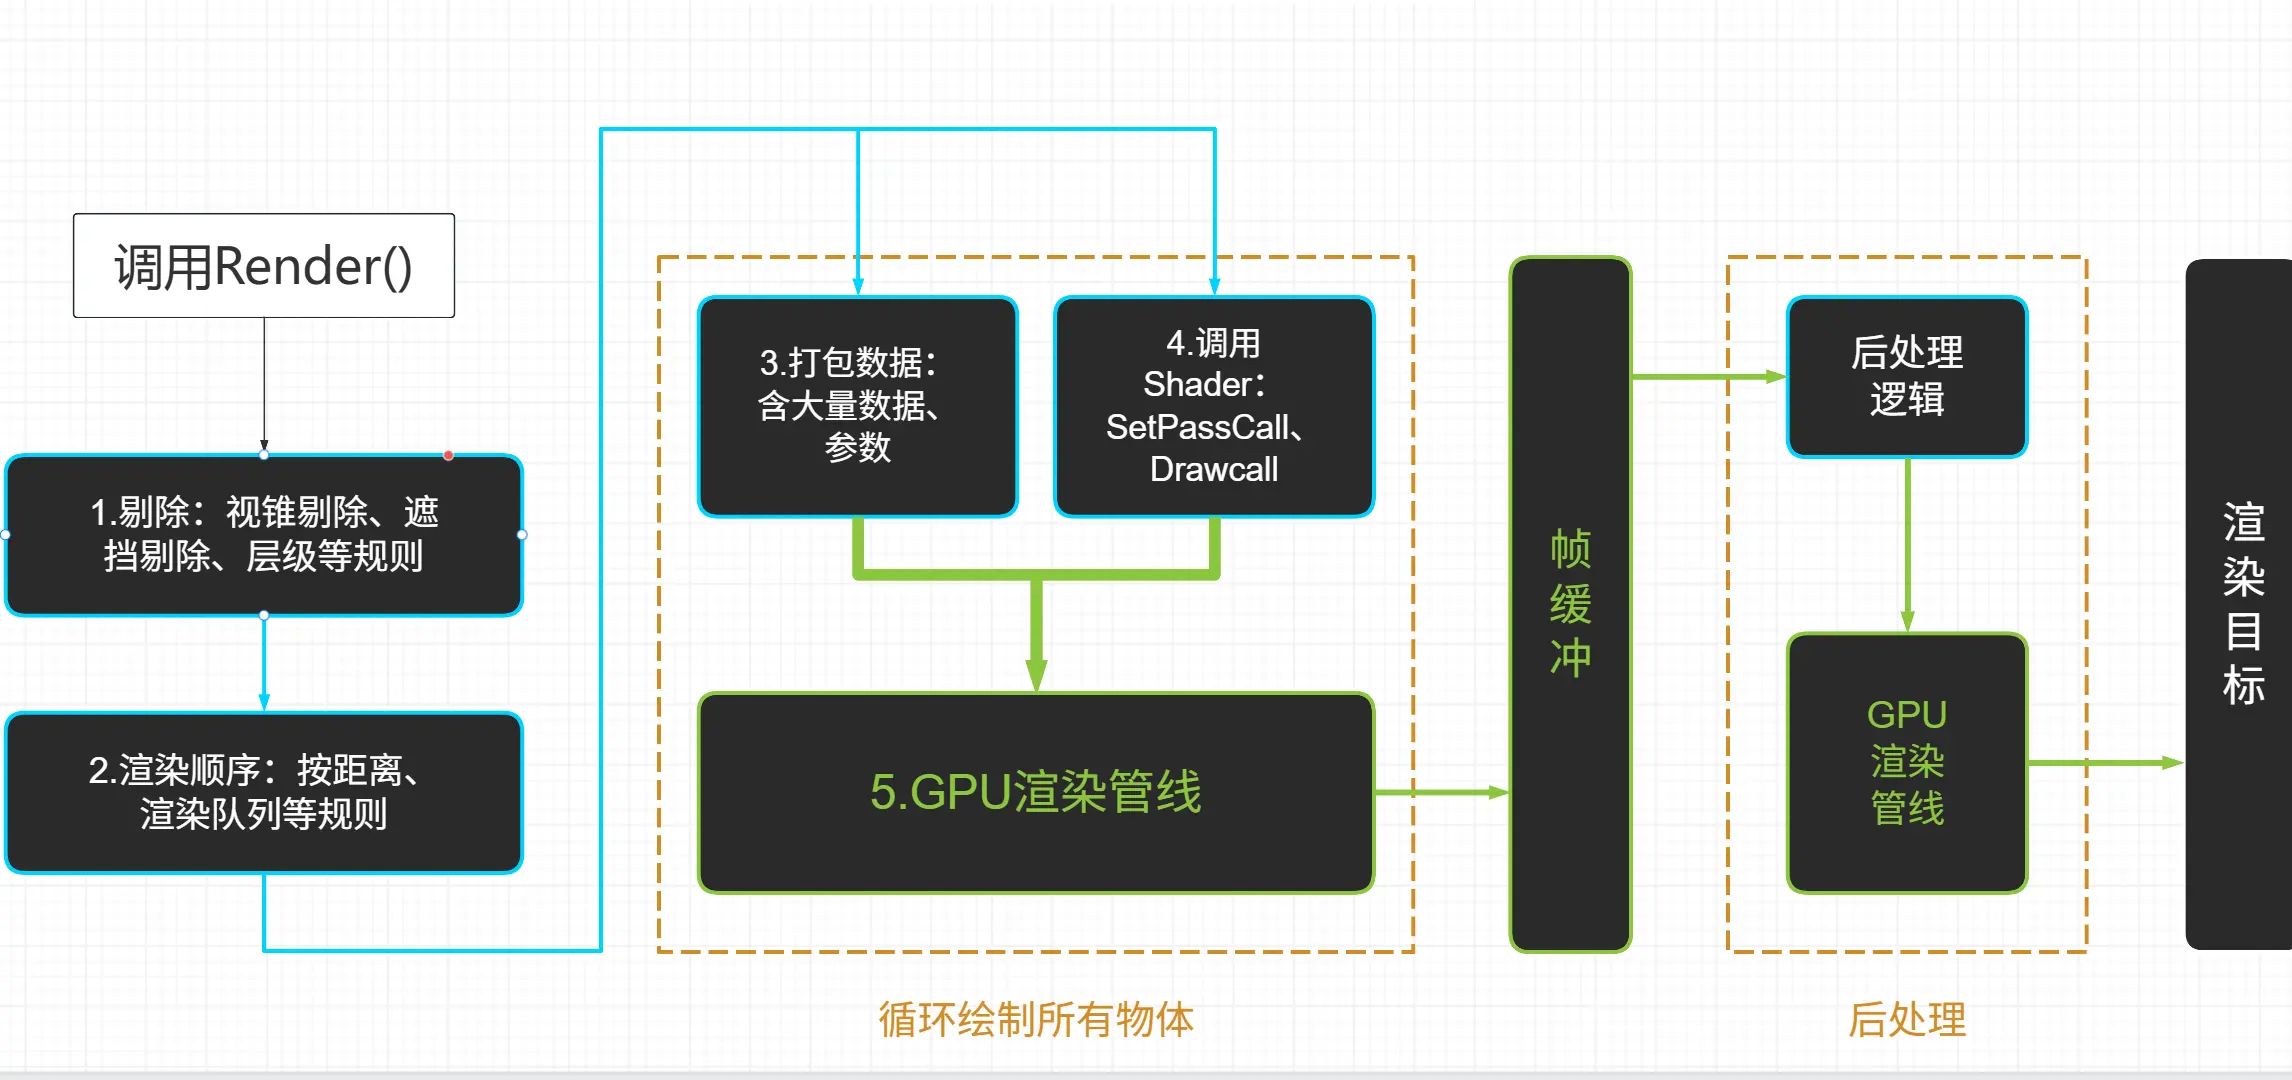
蓝色部分是CPU端要做的工作 绿色是GPU要做的工作。
步骤一:剔除,把不想要和看不到的物体进行排除
步骤二:确定渲染顺序,确定提交数据的顺序。
步骤三:打包发送数据。
第四步:调用对应工具
第五步:GPU收到CPU传来的信号,开始工作。(工序)
然后开始渲染图像,把对应内容渲染到帧缓冲区的位置,可以把帧缓冲区看作一个画布,然后我们屏幕可以从帧缓冲区拿到相对应的数据进行后处理,然后把这些数据显示到我们的屏幕面前。
后处理操作是CPU完成的然后调用Shader使用GPU渲染管线,对帧缓冲区图像进行二次修改,如调色、bloom等内容。
如果存在多个摄像机怎么办?
我们每个摄像机都会跑一遍这个渲染流程。
画出来的东西如何处理冲突?
每一个摄像机在显示出来之前都有一个清除的步骤,对应的是Unity中的clear flags
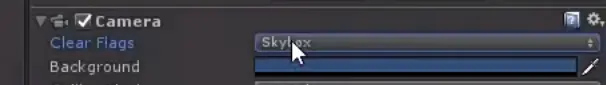
depth可以调整渲染顺序,数值越小越先渲染
简单来说就是:
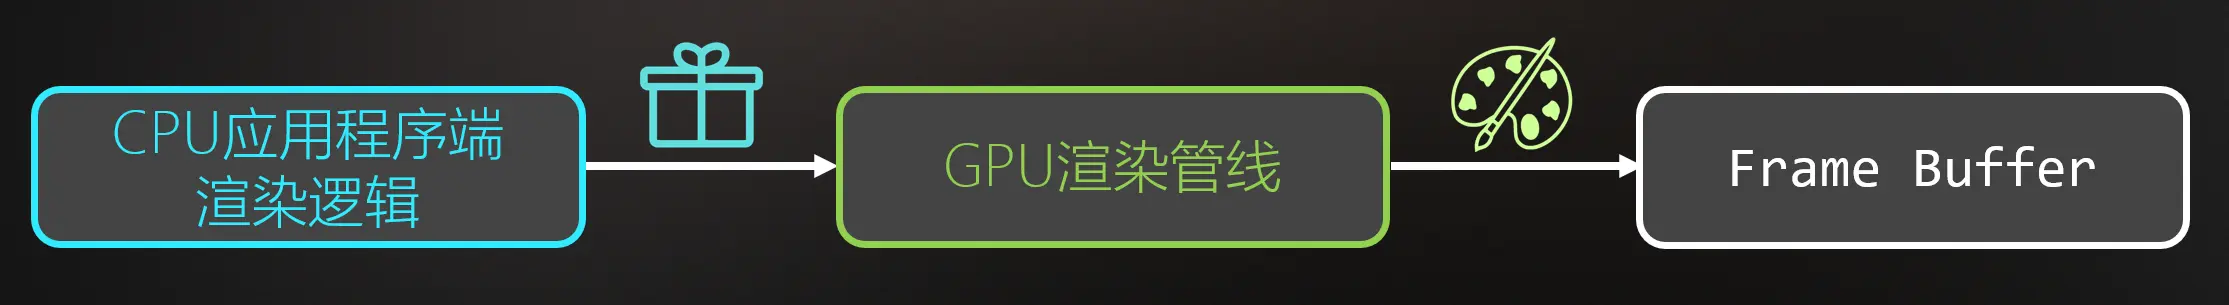
GPU渲染管线:
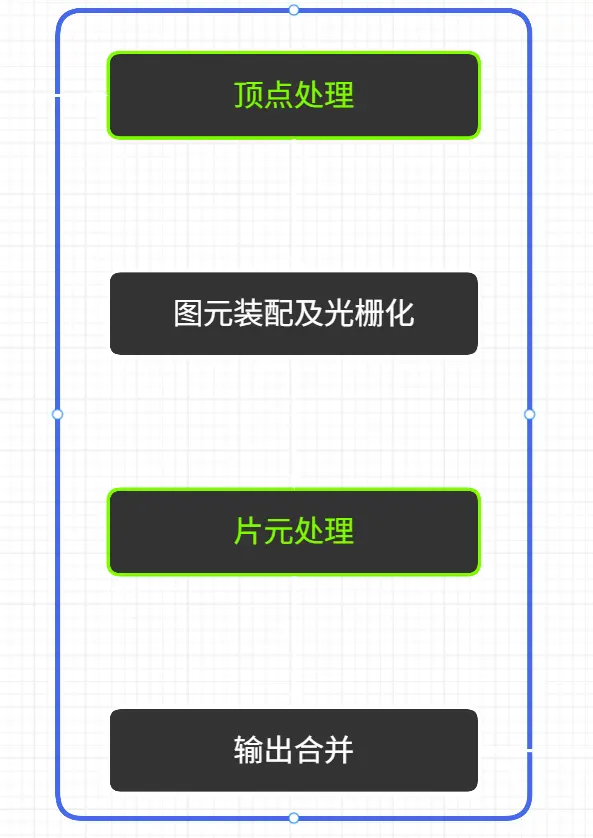
详解
应用程序阶段
剔除操作:
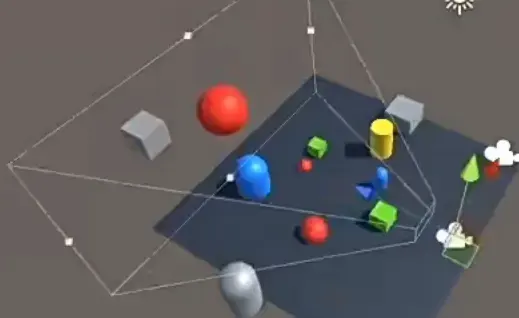
视锥体剔除指的是用FOV的参数 近裁面和远裁面组成的立方体金字塔,模型和视锥体做碰撞检测,如果相交就是能看到的,如果看不到就会被剔除。如果物体复杂(网格多),会产生更多的性能消耗。所以在性能上我们使用AABB的包围盒(Box colider)。
层级剔除层级剔除,我们可以对一个物体设置一个层级然后在Camera中找到Culling Mask的选项,把对应层级关掉即可排除对应层级。
遮挡剔除:可参考遮挡剔除 – Unity 手册,摄像机在每一帧中执行剔除操作,这些操作会检查场景中的渲染器,并排除(剔除)那些不需要绘制的渲染器。默认情况下,摄像机执行视锥体剔除,这一过程将排除所有不在摄像机视锥体范围内的渲染器。但是,视锥体剔除不会检查渲染器是否被其他游戏对象遮挡,因此 Unity 仍会浪费 CPU 和 GPU 时间进行在最终帧中不可见的渲染器的渲染操作。遮挡剔除将阻止 Unity 执行这些徒劳的操作。遮挡剔除会在 Unity Editor 中生成有关场景的数据,然后在运行时使用该数据来确定摄像机可以看到的内容。这种生成数据的过程称为烘焙。
排序操作:
- 渲染队列:
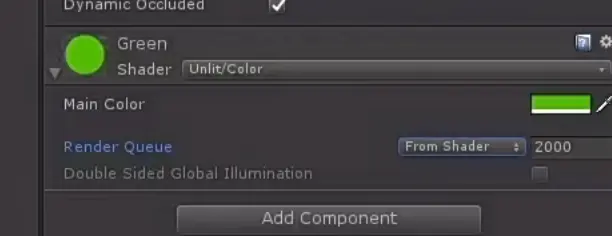
在材质上有这样的数值,如果数值越小应该越先被渲染。
大前提:如果Render Queue的数值相等
- 不透明队列(Render Queue<2500):按摄像机距离从前到后排序。
- 半透明队列(Render Queue>2500): 按摄像机距离从后到前进行排序
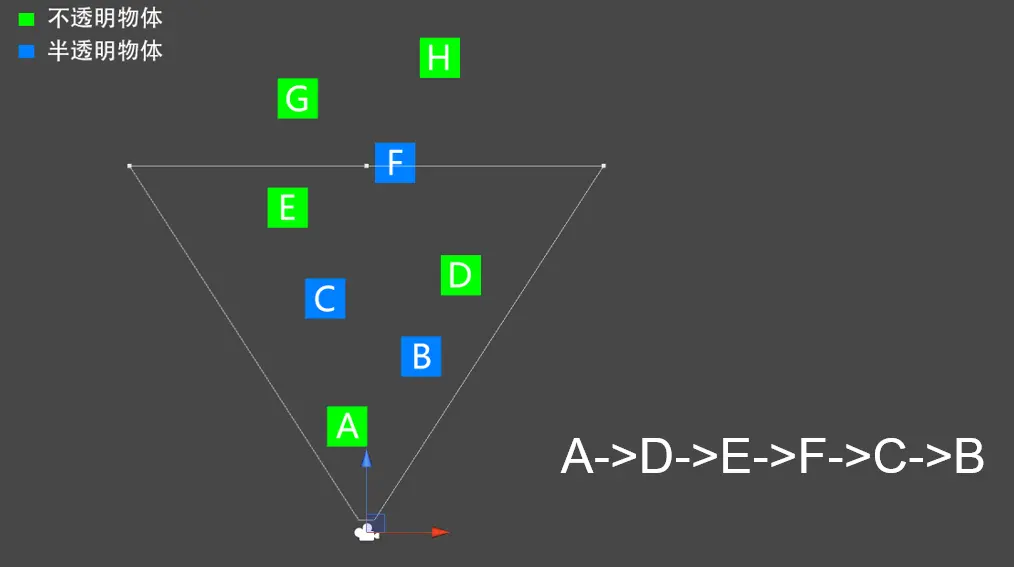
为什么要按这个顺序进行渲染排序,主要目的是为了优化,假如前面的物体先被渲染,那后面重叠的部分就可以省略了,因为是被遮挡到的,可以不用重复渲染减少部分性能开销。
半透明队列顺序的用意:渲染效果的正确性,必须从后到前,严格顺序才能保证渲染正常。
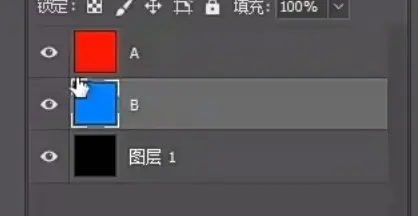
假如透明度都是50%,谁最后渲染效果是不一样的,如果B在上那显示的是B的颜色,A在上显示的是以A为主的颜色。所以要按从后到前顺序渲染才能保证效果的正确。虽然我们这个能大体保证从后到前的顺序进行渲染,但当物体过于复杂我们无法保证排序的正确性。
先渲染不透明物体,然后渲染半透明物体。
至此排序后就可以打包模型数据提交到GPU端
打包的数据
模型信息:
- 顶点坐标
- 法线
- UV
- 切线
- 顶点色
- 索引列表
变换矩阵
- 世界变换矩阵
- VP矩阵:根据摄像机位置和FOV等参数进行构建的
灯光材质参数
- shader
- 材质参数
- 灯光信息
探索模型相关内容
建模软件内我们一般使用4边形进行建模,但是我们游戏引擎只能识别三角面。四边面导入后会自动转换成三角面。
一个obj内有这些参数:
这是一个立方体的obj。顶点信息就是一堆三维数据。
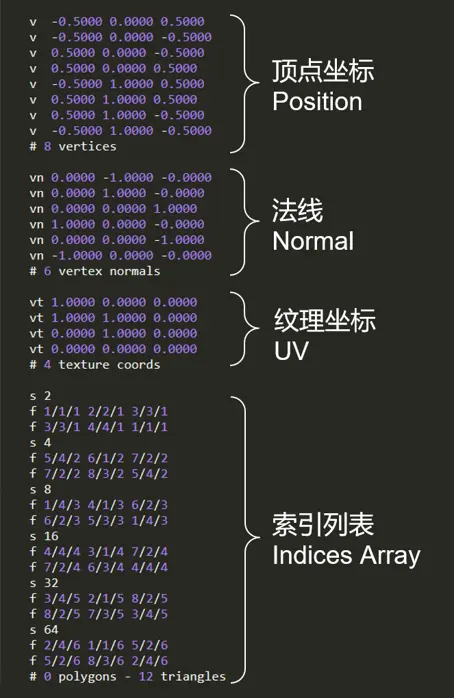
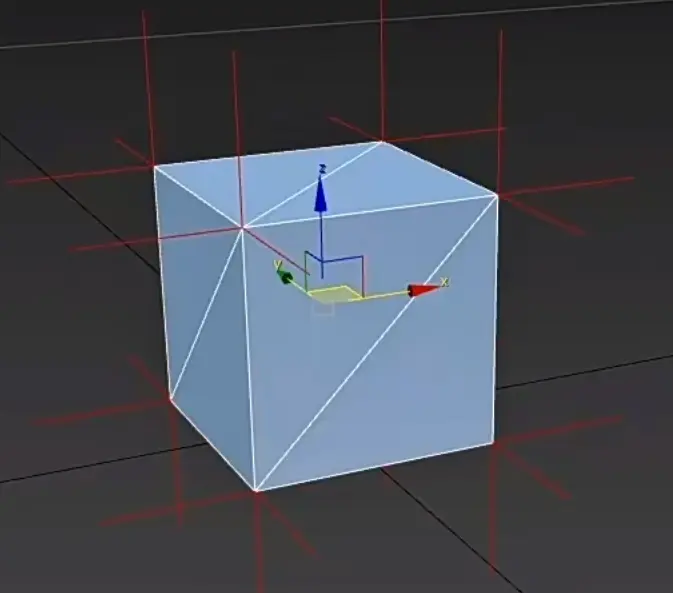
我们在建模软件中可以观察到有24个法线,为什么到这里只有6个了,因为法线重合了,他把相同数值法线进行了合并。UV也是同理。
UV是一个二维数据 只有两个分量可以用。
索引列表,1/1/1 按顺序讲解,第一个1 对应着顶点组,第二个1对应着第一个法线,第三个1对应第一个UV。
索引列表在此起到了很重要的作用,如果没有这个列表就会有很多的冗余数据。
绘制调用
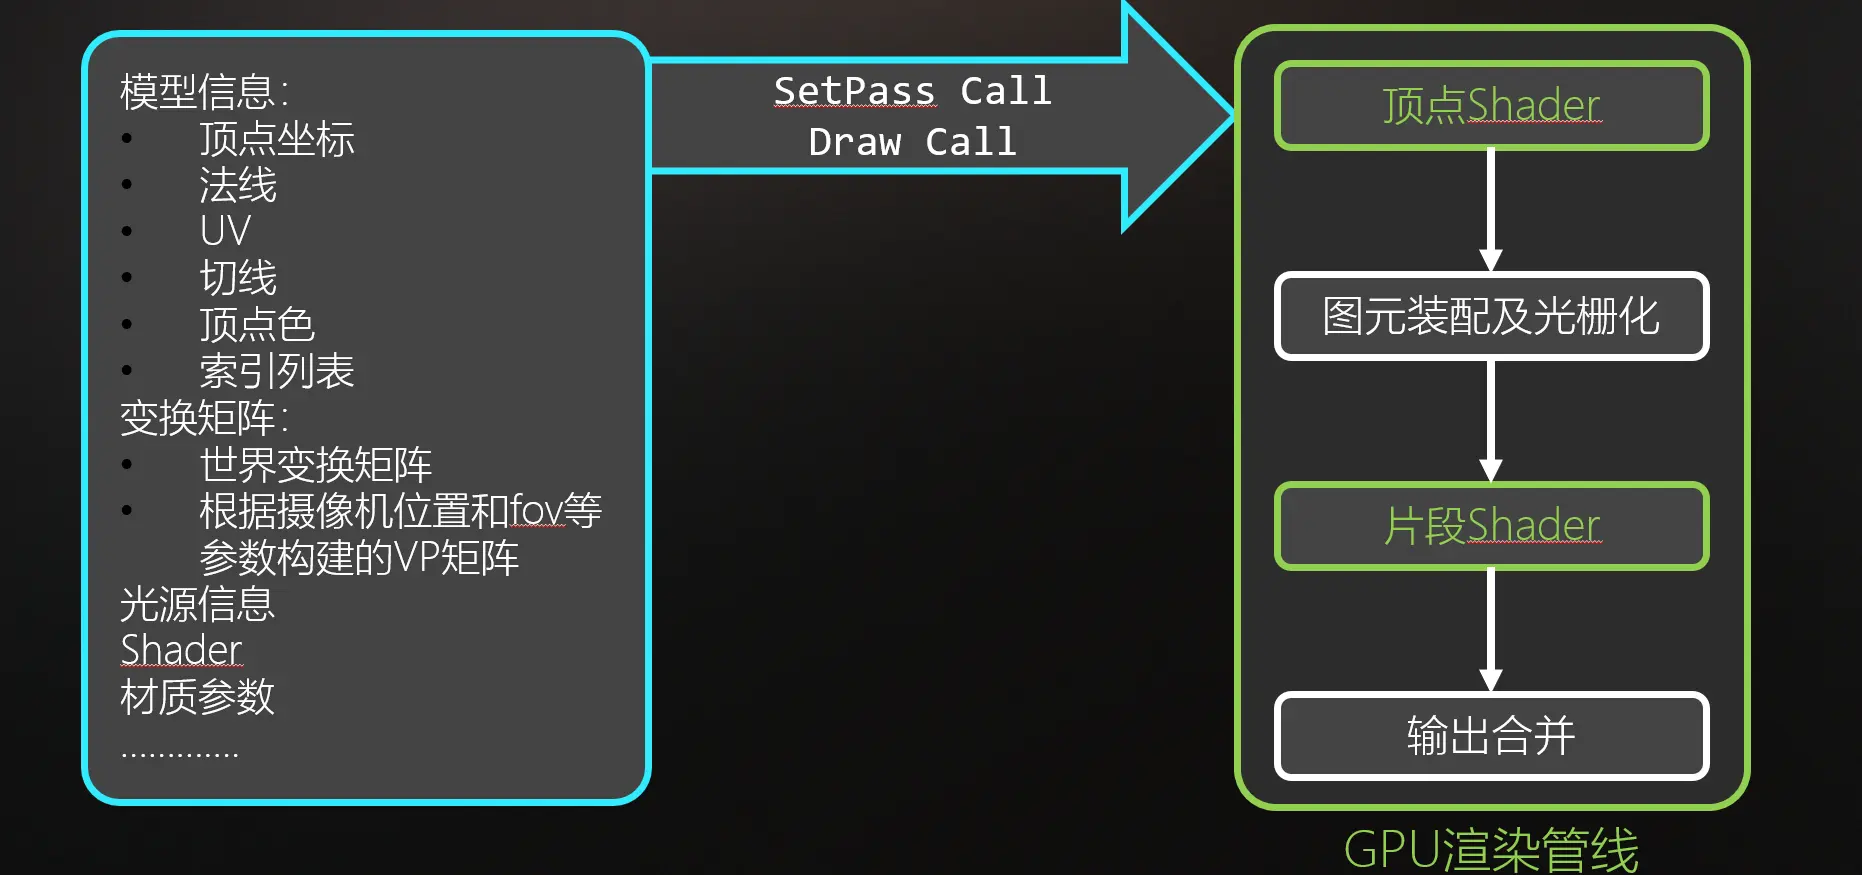
把数据包发送调用指令,然后GPU渲染管线就可以开始工作了。
GPU渲染管线
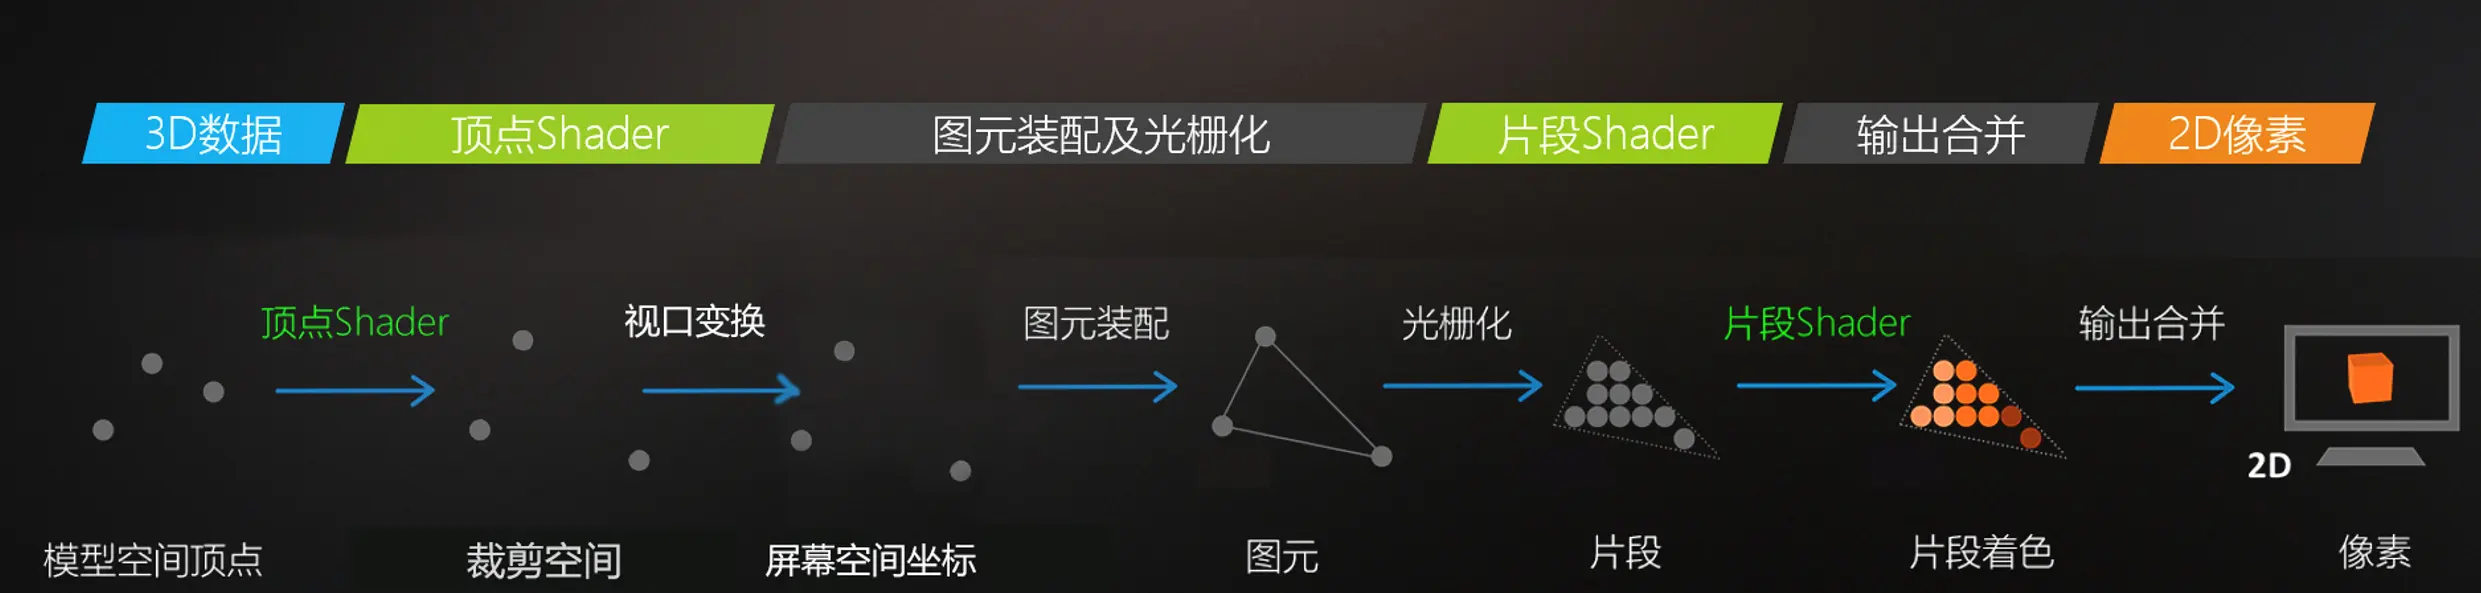
顶点Shader: 通过模型空间的顶点,模拟投影成像,完成从3D->2D的转化。
模型空间顶点: 生成的模型数据。
视口变换:视口变换转换到屏幕的空间坐标系上。
屏幕空间坐标:只是把点映射到了屏幕上面,但并没有形成对应的2D像素点。
图元装配:把点连成线,组装成三角形,生成的三角形叫做图元。
光栅化阶段:对图元内部进行插值计算生成片元/片段。
片元可以把他理解为没有显示到屏幕上的像素。目前还没有决定是什么颜色的像素和是否这个像素能够显示到屏幕上。
光栅化结束后就意味着我们实现了从3D转化到了2D的过程了。(变成像素点了)
片元shader:给片元进行上色,光照计算,纹理映射等。
输出合并:一个片元可能有多个片元竞争,有很多复杂的关系,在此阶段进行处理最终成图。
完整的shader
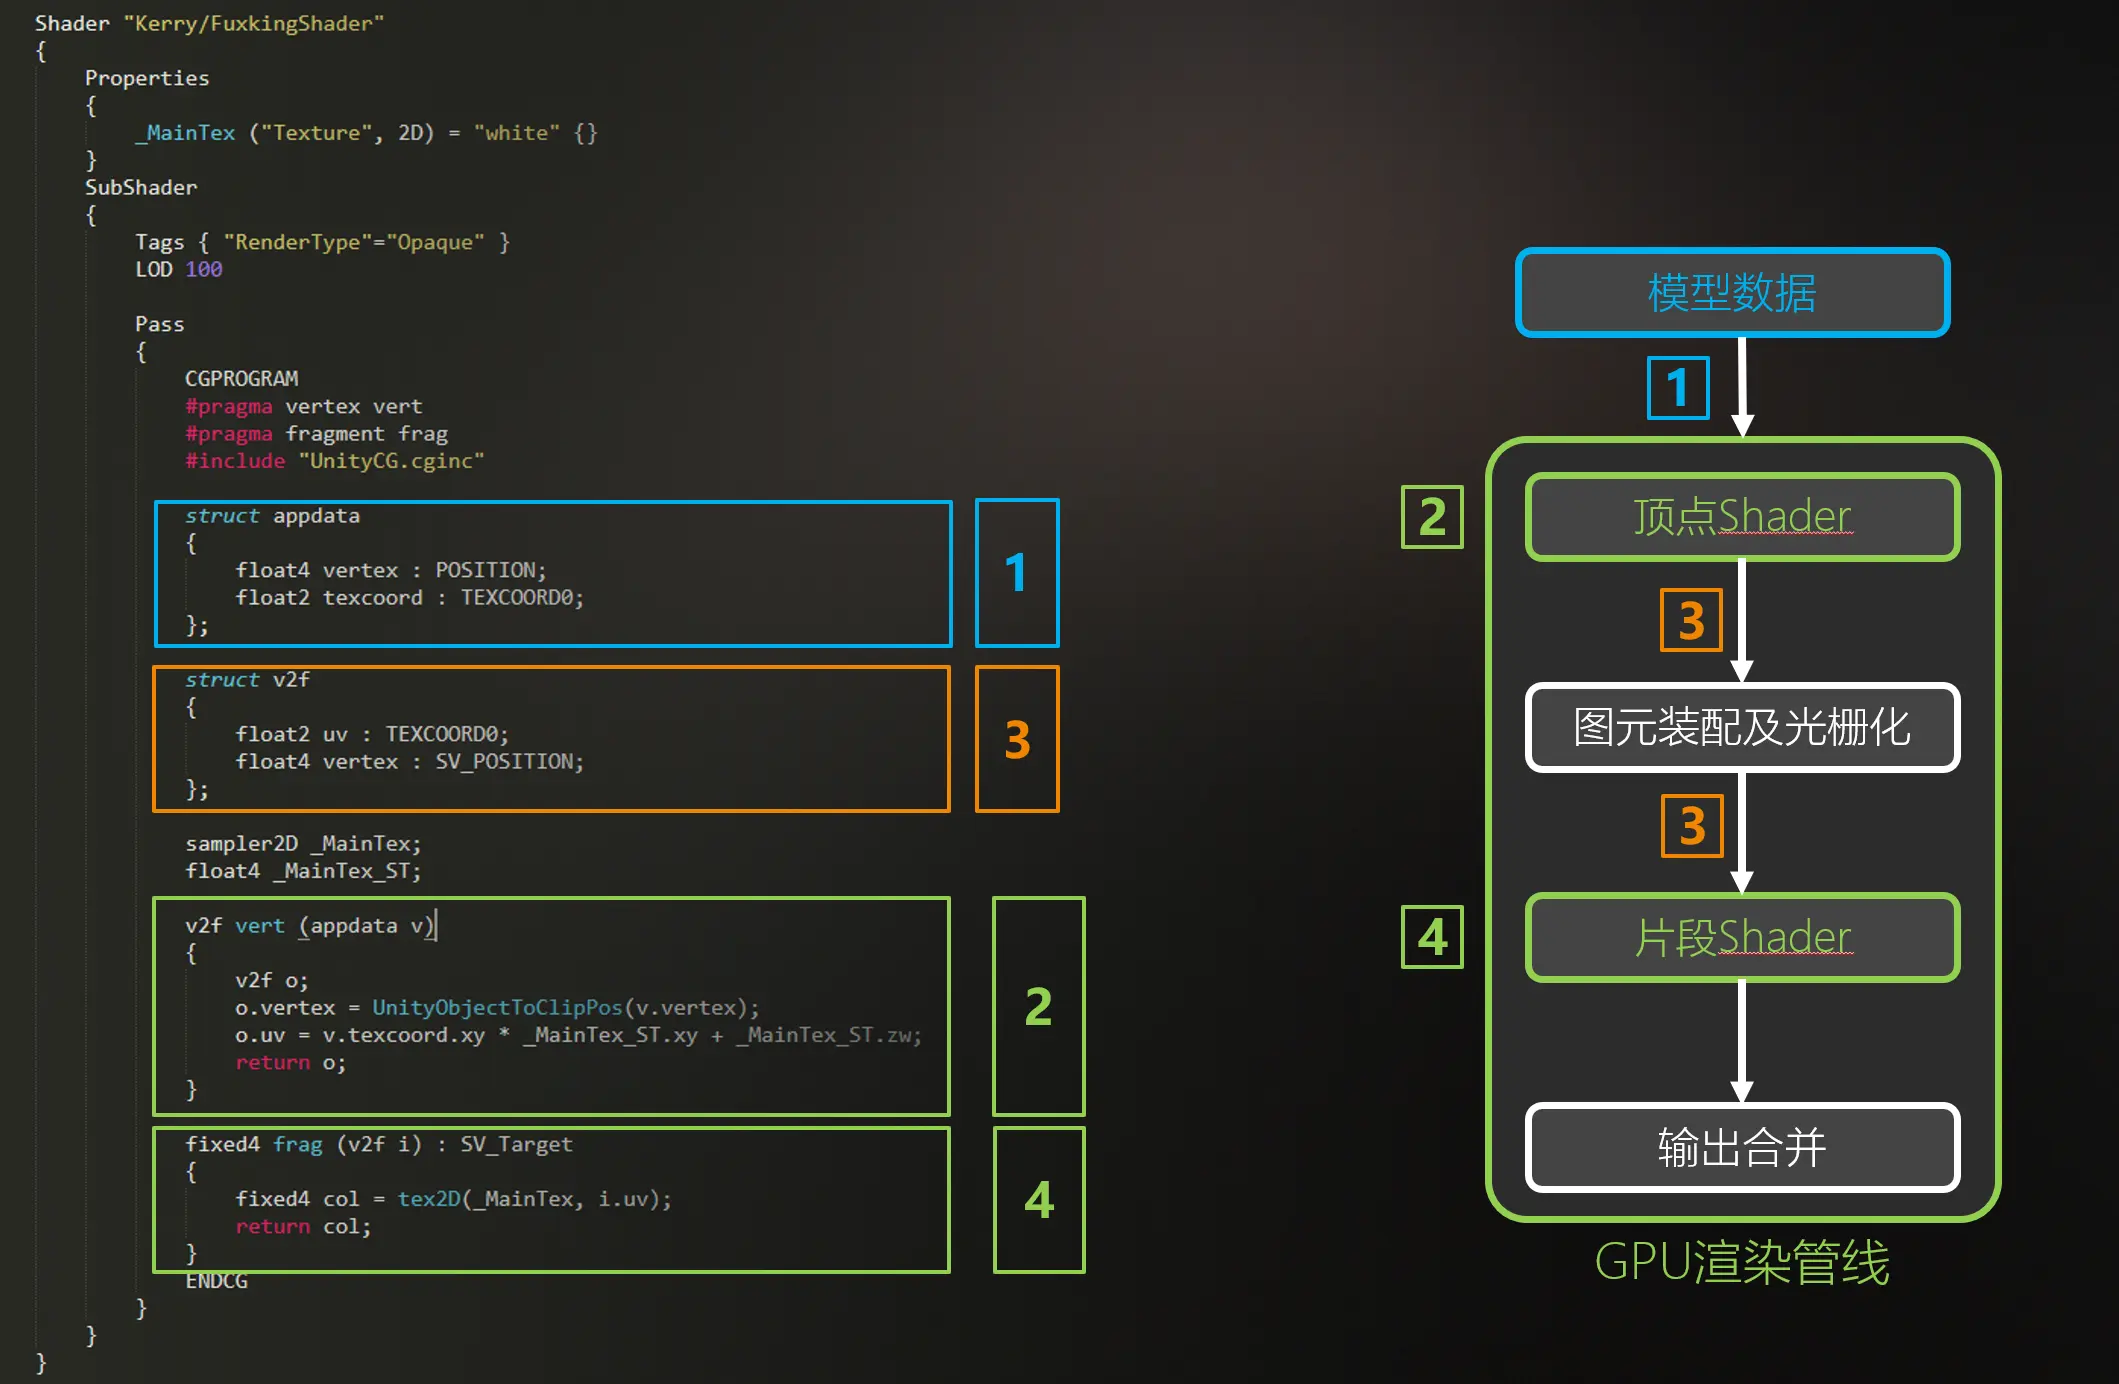
第一步对应的代码告诉需要坐标和顶点uv,可以自定义。拿到对应数据就可以到顶点shader,也就是第二段,即为顶点shader,主要任务是完成投影成像,要把模型空间下的顶点坐标转换到裁剪空间完成边形操作,以便后续映射。
顶点输出内容也可以进行自定义,即第三部分代码,目的是为了方便片元进行后续处理。
硬件阶段会进行图元装配和光栅化,每一个片元都会携带着我们第三部分自定义的数据。
顶点shader
最重要的任务:将顶点坐标从模型空间变换到裁剪空间。
通俗地讲:模拟“拍照“的过程,模拟投影成像的过程,将我们的3D模型进行变形.
经过顶点Shader处理后,相机金字塔状的视椎体被转换变形成一个比例为2x2x1的立方体(CVV)。
顶点Shader并不会产生2D图像,仅使得场景中的3D对象产生变形效果。
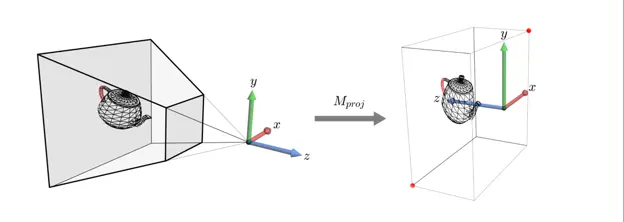
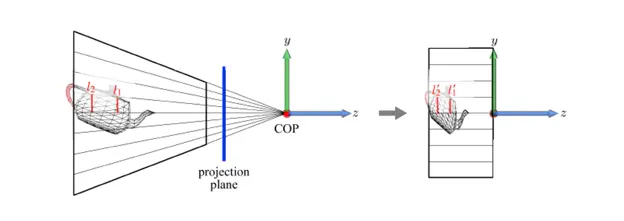
我们为什么要做这个变形,从侧视图可得,如果把茶壶压扁就可以变成2D图像,但是因为有多物体遮挡问题,本步骤只是模拟3D->2D的过程,但最终拍扁成为2D 二维形式仍需要留给后续硬件处理。
顶点shader并不会产生2D图像
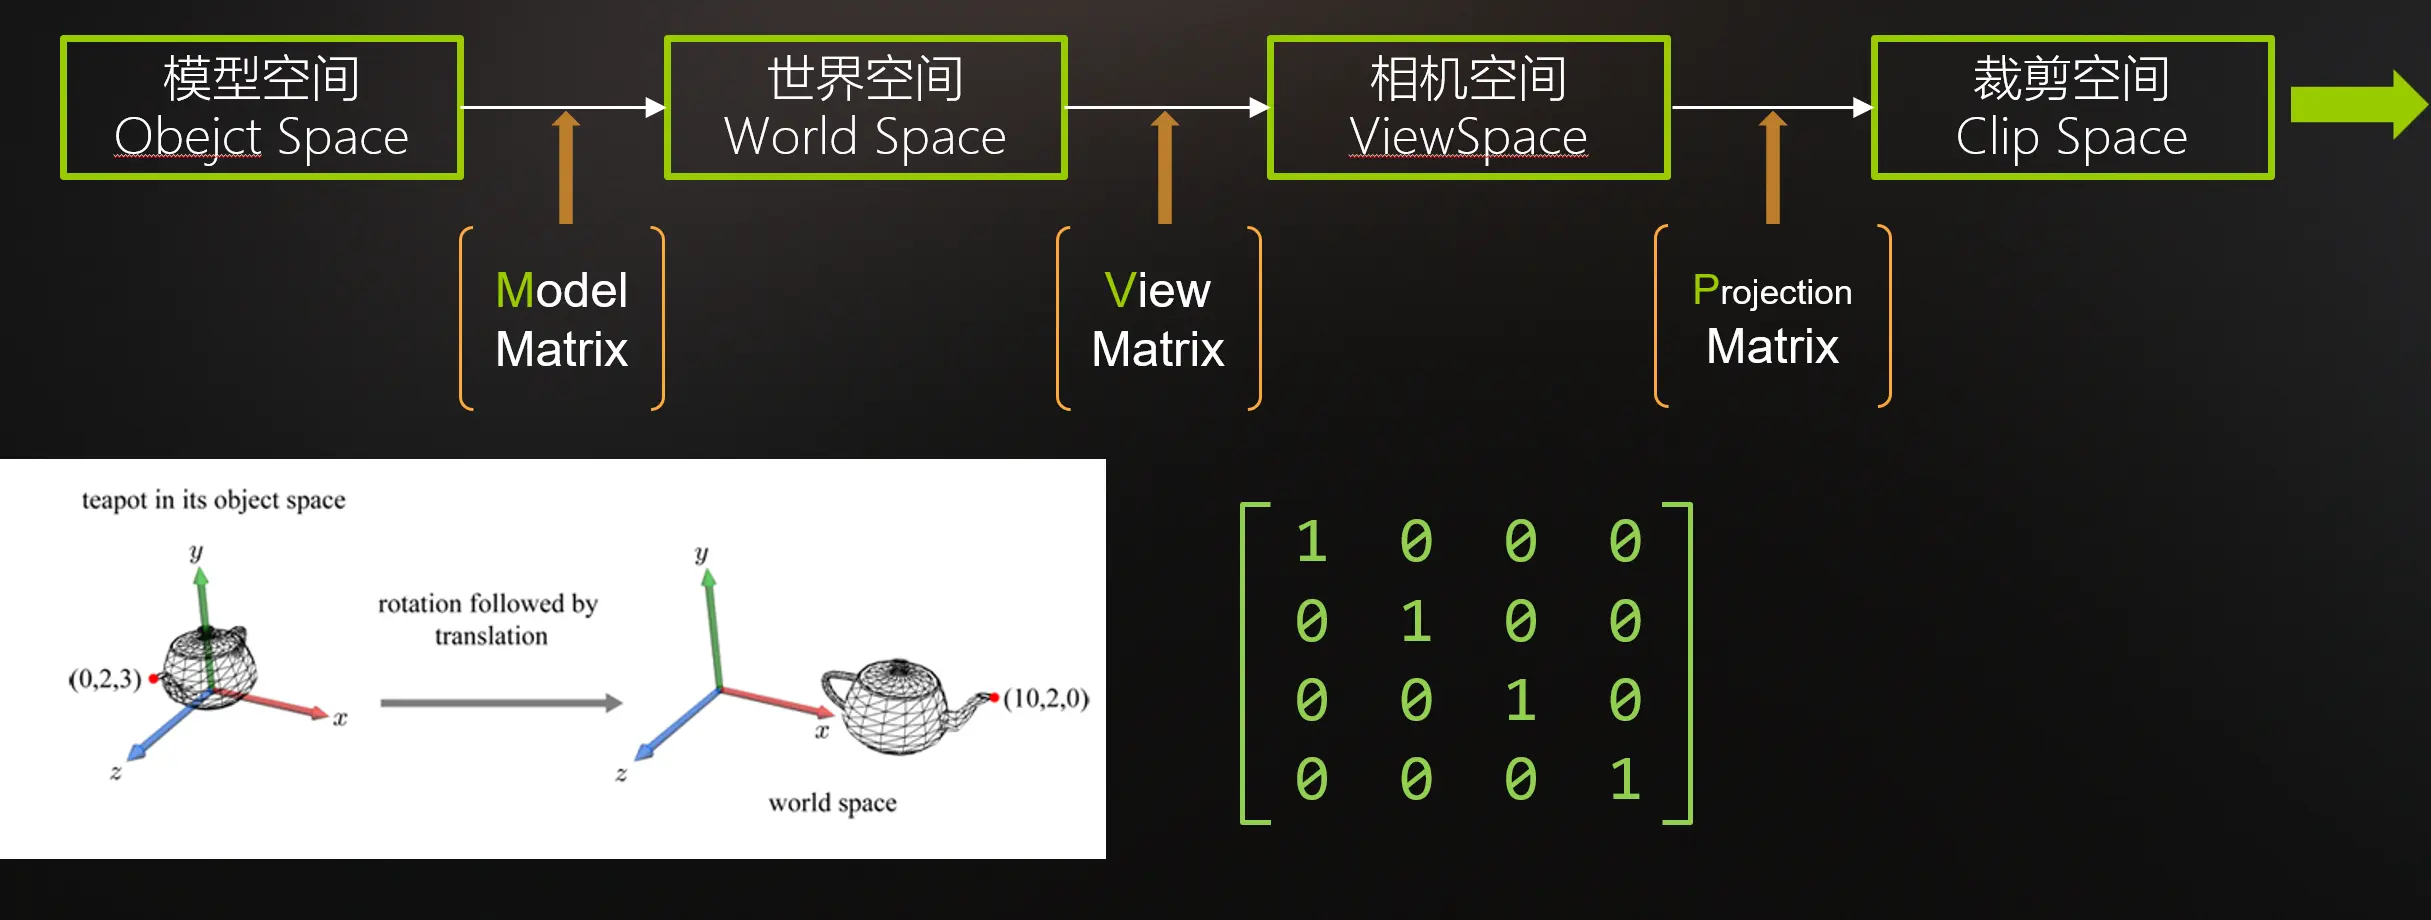
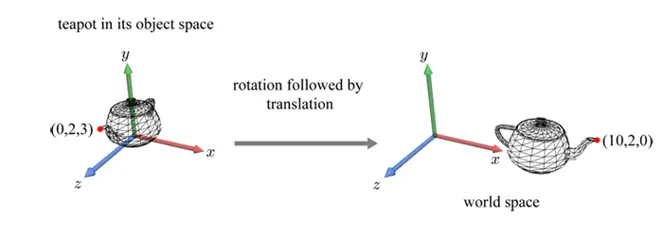
从模型空间->到世界空间 是unity 给的一个矩阵进行转换。
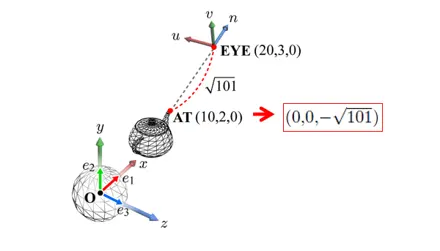
站在摄像机位置重新观察物体,坐标就会发生改变,因为参考系发生了改变。对应关系也可以通过变换矩阵来解决。
把三维物体按照近大远小来映射,使用投影矩阵。
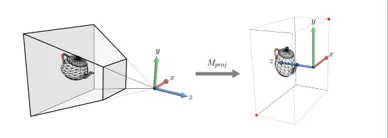
进行过后我们的模型就在裁剪空间的位置。
上面所说的三个矩阵即为MVP矩阵。
硬件操作阶段
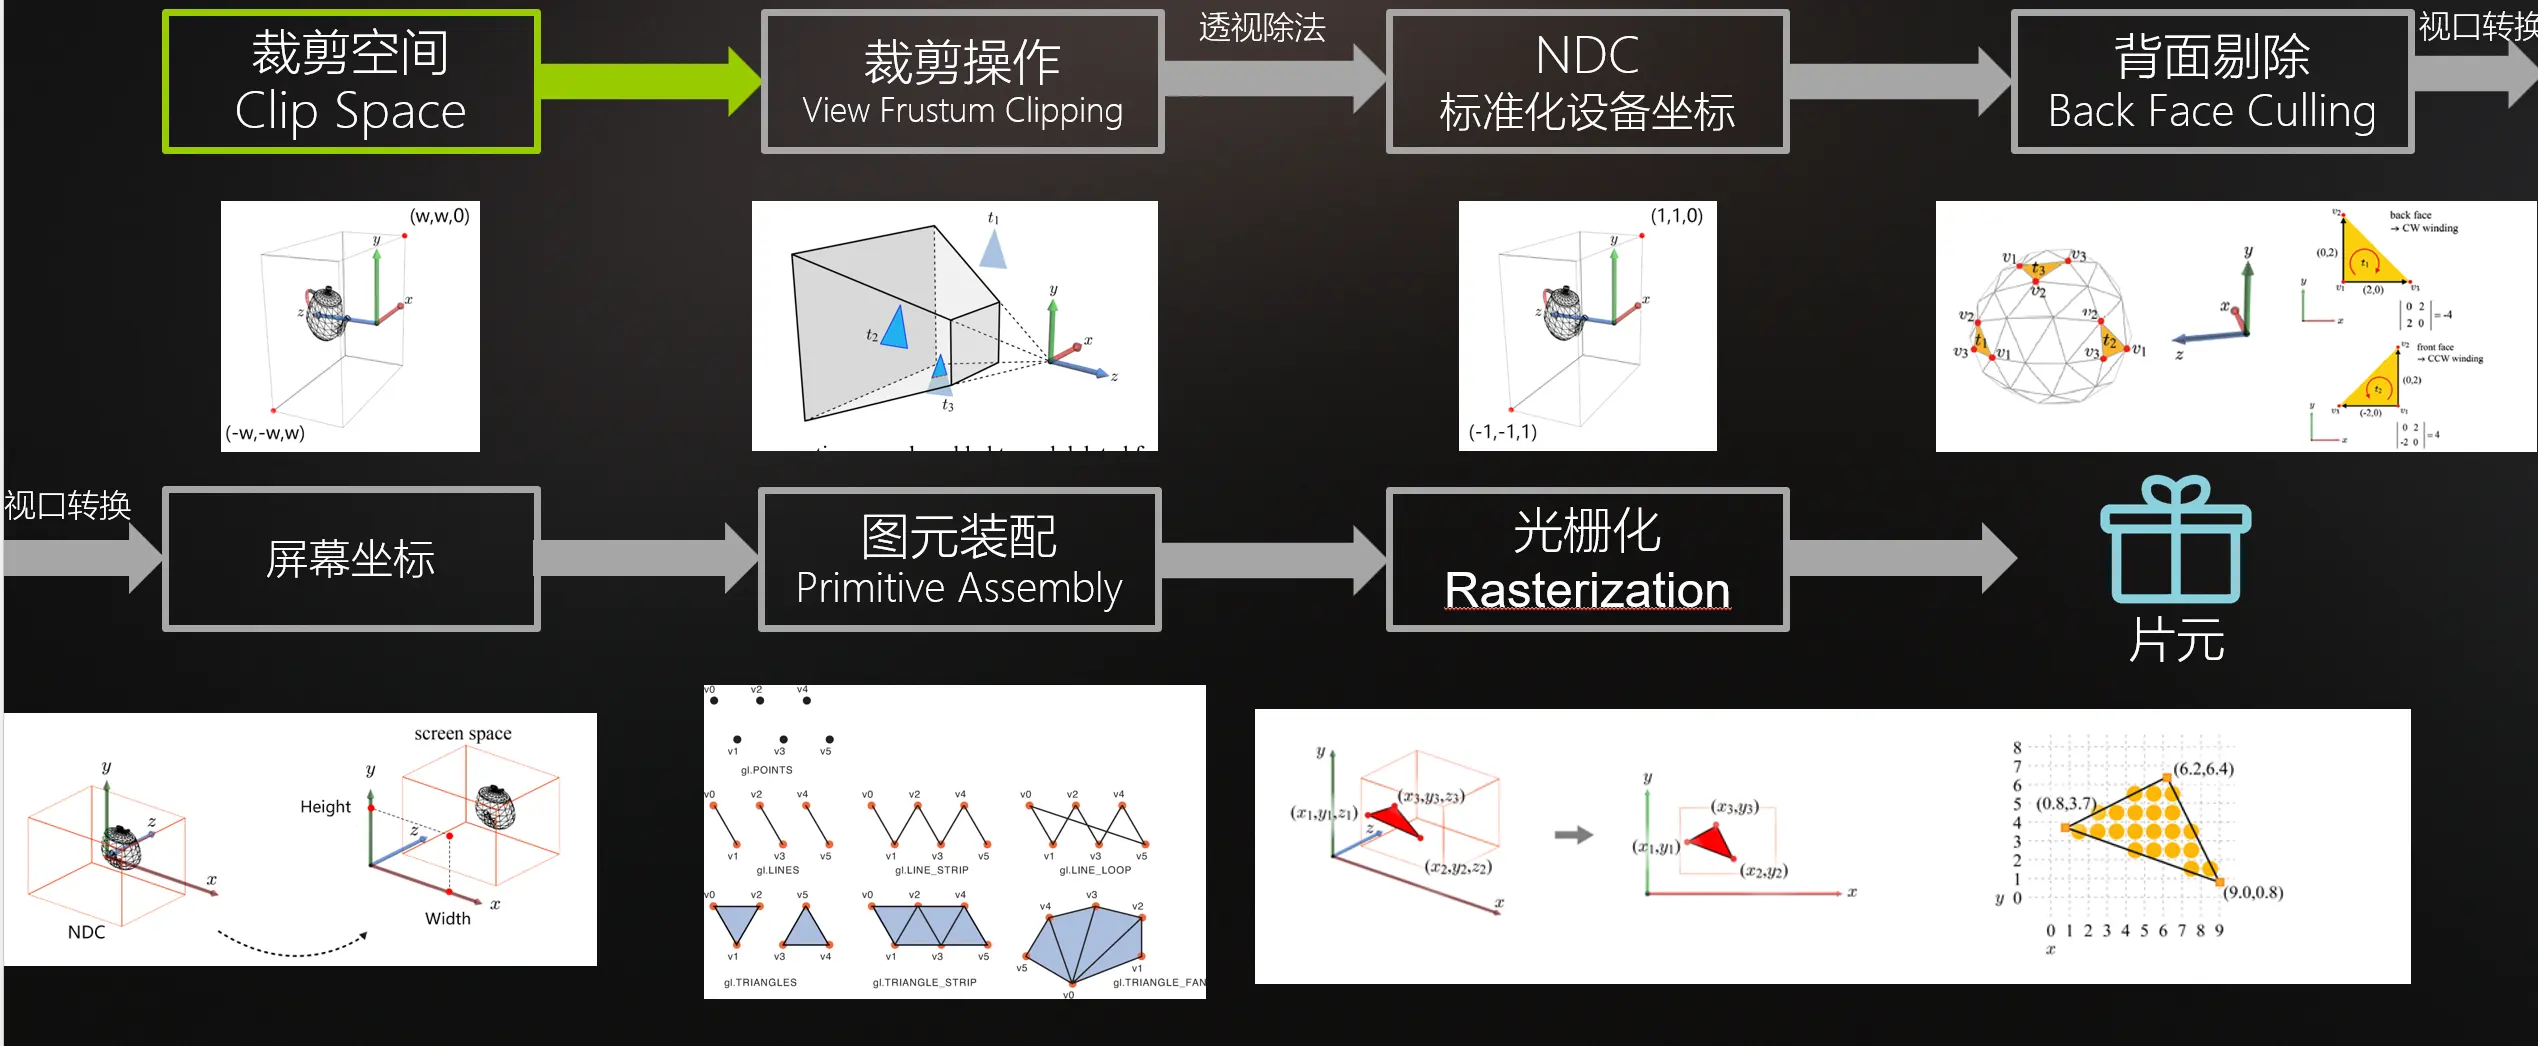
这个步骤就裁剪空间是值得讲解的,因为剩余的操作都是硬件完成。
先讲解一下裁剪操作。
裁剪操作:前面提到了视锥体剔除,那个是针对整个大物体的。裁剪操作是针对微观三角面的,假如三角面和视锥体有交界的部分,那就会被剪掉,然后沿着视锥体的那条切线生成一个新的三角面。他不会丢弃只会裁剪。
裁剪空间(clip space):因为裁剪操作在金字塔内很难判断这个三角面哪一部分是需要裁掉的(交界难判断),这个裁剪空间是221的长方体,范围在-w~w之间,depth在0-w之间,如果超过这个范围之外那就是超出视锥体之外,就应该裁剪掉。所以我们应该在裁剪空间内进行裁剪操作。
透视除法:裁剪后转换到NDC上,即归一化[-1,1]。
显示器左下角是(0,0),右上角坐标根据屏幕坐标而定,所以我们转换到这个范围更方便多分辨率映射。
背面剔除:把背对摄像机的三角面给剔除掉
如何确定是否是背面:
NDC标准化坐标系,Z轴方向是摄像机观察方向,取xOy平面,以及参考索引列表。
如果该屏幕内索引是按照顺时针分布的话,就认为是背面,如果逆时针那就是正面。
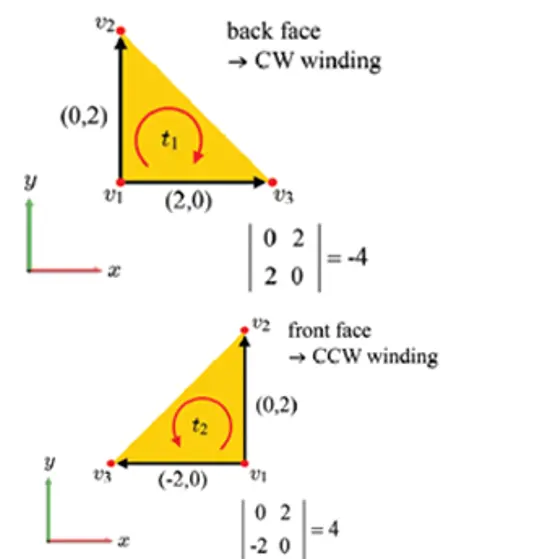
可以参考games101数学矩阵讲解。
视口转换:转换到对应屏幕的坐标系。按屏幕分辨率进行转换,屏幕坐标转换只针对xy坐标,z坐标要处理是后面光栅化处理关系用的。
光栅化:对图元的内部插值算法生成片元,光栅化的过程相当于把3D的顶点变成2D的过程,xyz坐标只用xy坐标 直接进行压扁,在2D的图像上进行插值,z值放在顶点上,通过插值算法会把对应的插值补全到每一个片元上。NDC的z值就变成了深度值。
因此我们可以通过z值来判断这些片元的前后遮挡关系,从而帮我们更好的实现效果。也可以插值生成各种的数据,顶点色插值生成。
可以看一下这个视频:
我们用矩阵来存储坐标和对应rgb颜色值
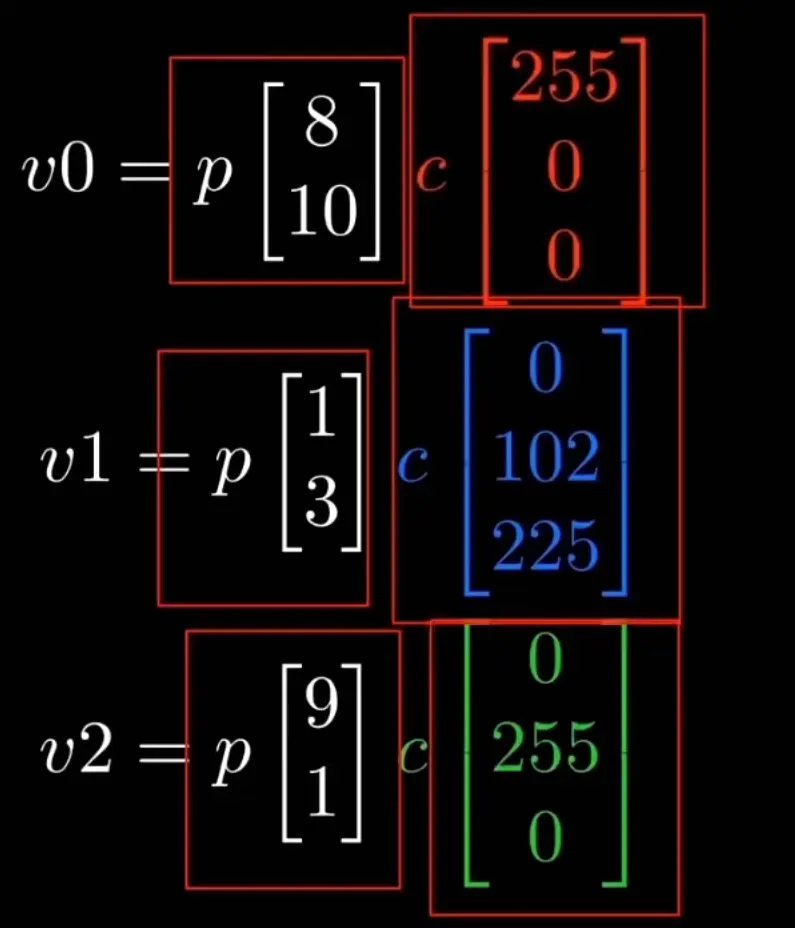
p表示方位矩阵,c表示颜色矩阵
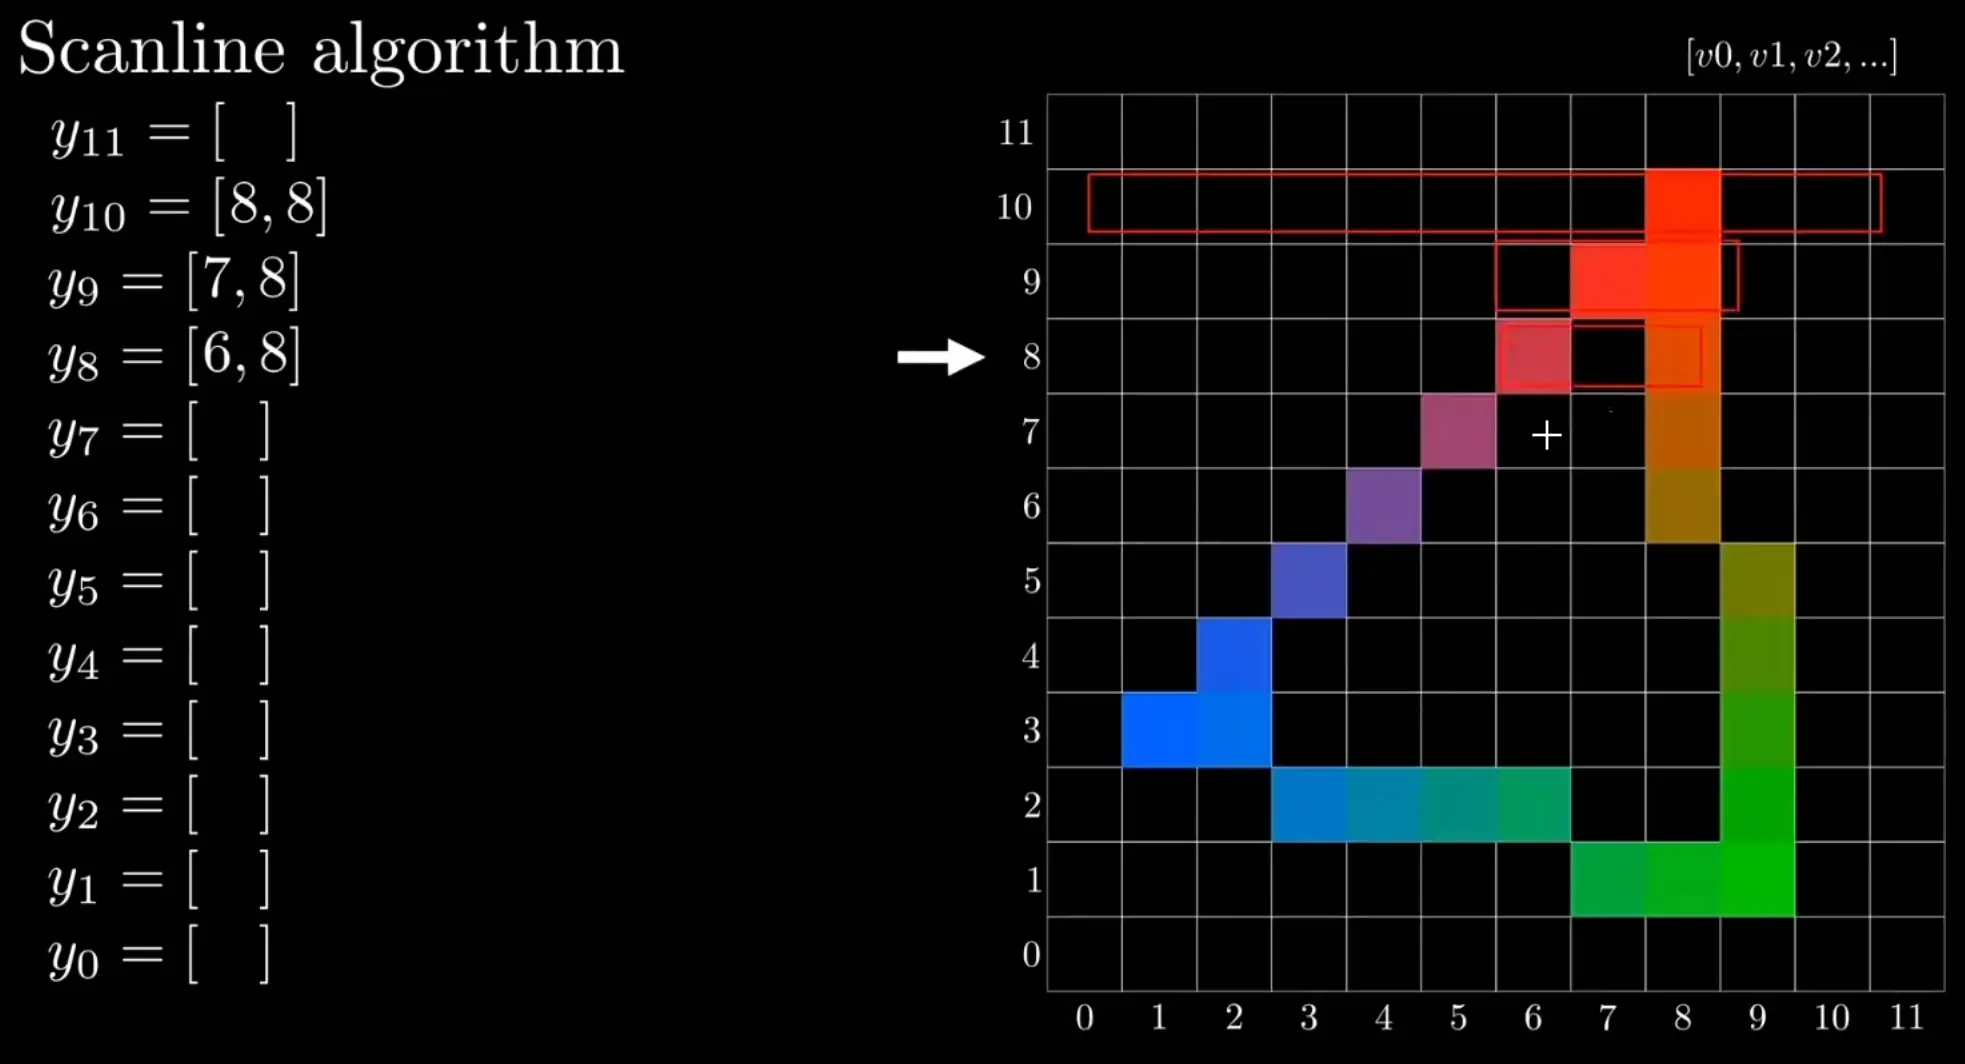
通过方位两点连一条直线判断经过哪些像素。
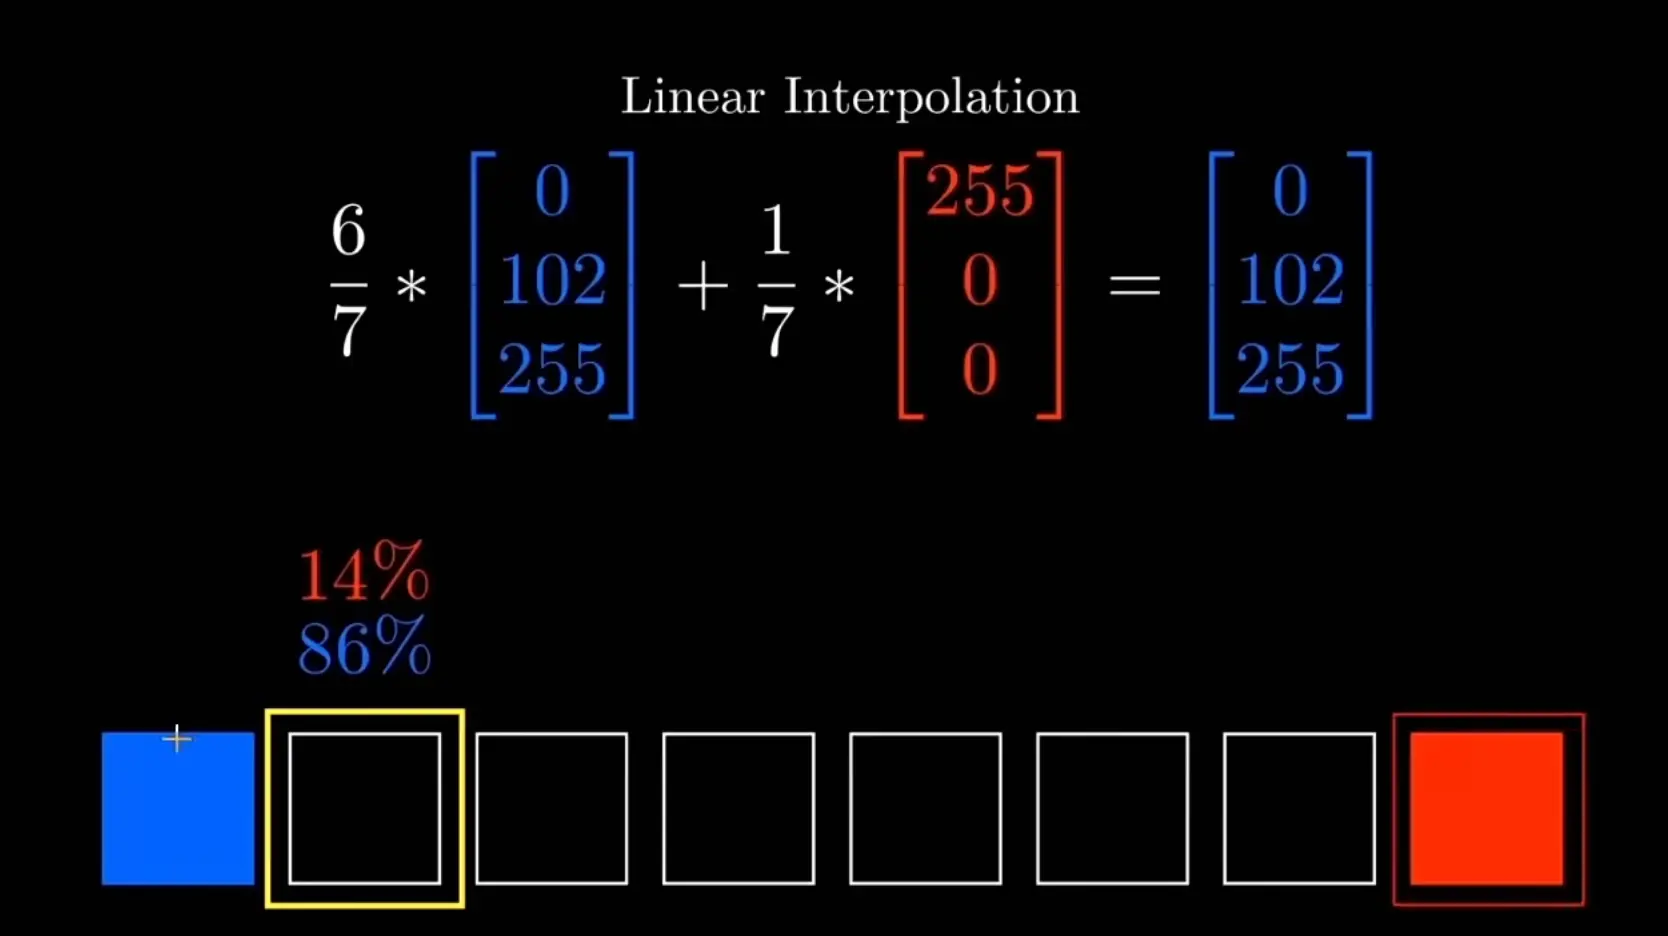
线性插值公式。
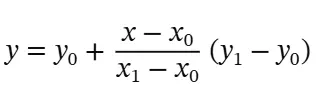
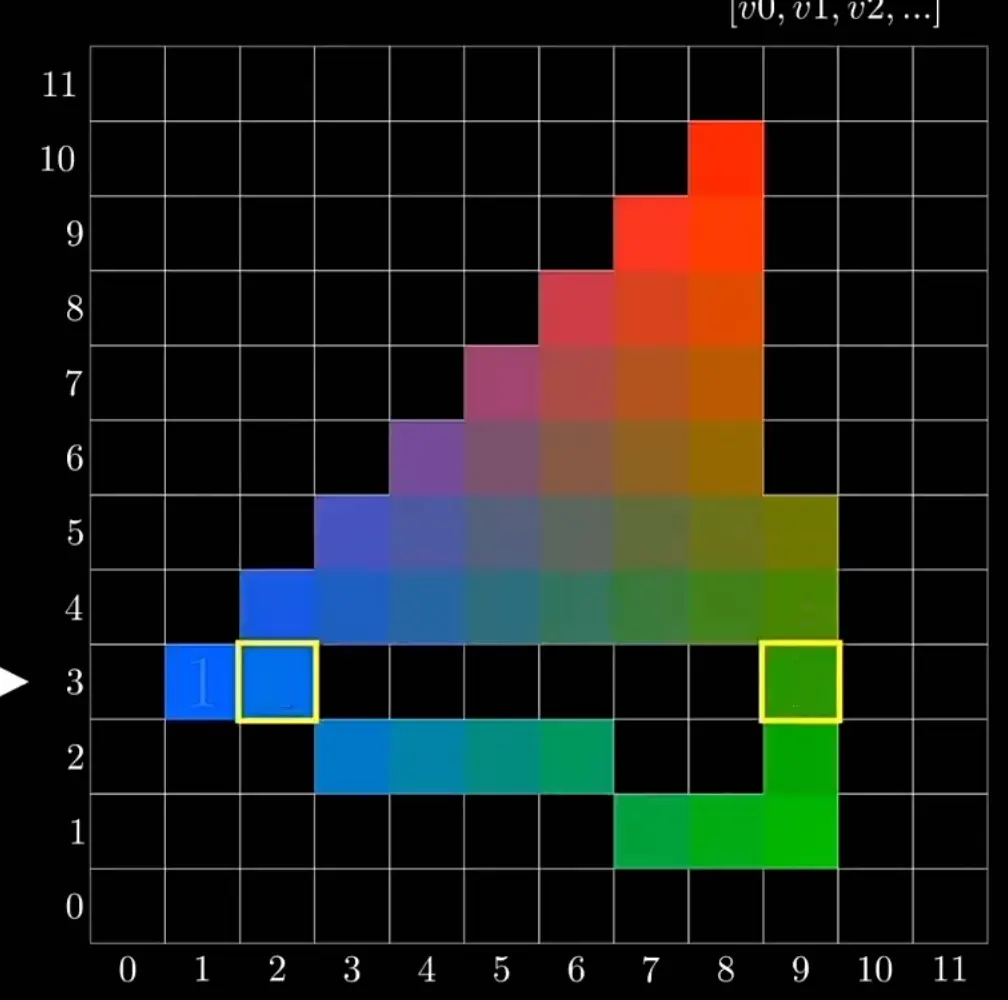
填充颜色后再逐行插值
光栅化会产生锯齿。
我们每一个片元有这些数据:
- 深度值Z
- 法线
- 顶点色
- 切线
- 位置
- 所有自定义的数据
深度值是必须有的
片元shader
纹理技术
像素需要存储会产生纹素地址,可以用二维数组实现。
纹理采样:采样纹理坐标,可以对应到一个纹素地址。
纹理坐标:一个二维的数值,在建模软件生成或shader自定义。在展uv过程中我们需要给他赋予坐标。
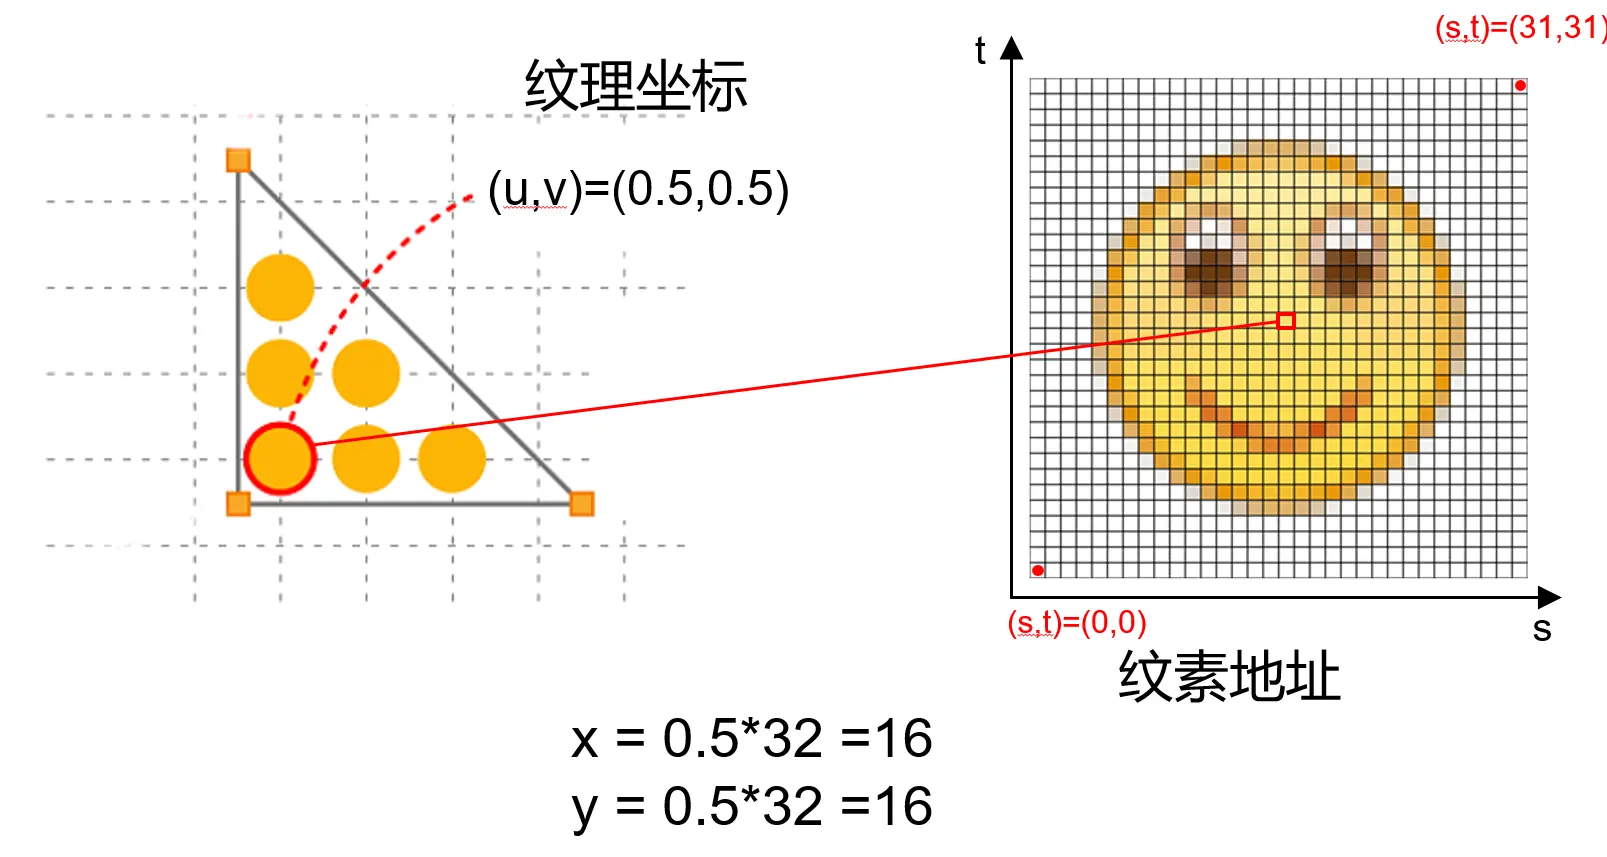
不是整数值的话要有纹理过滤机制,如果粗暴的向上取整,如下图会产生大量的锯齿(失真)。
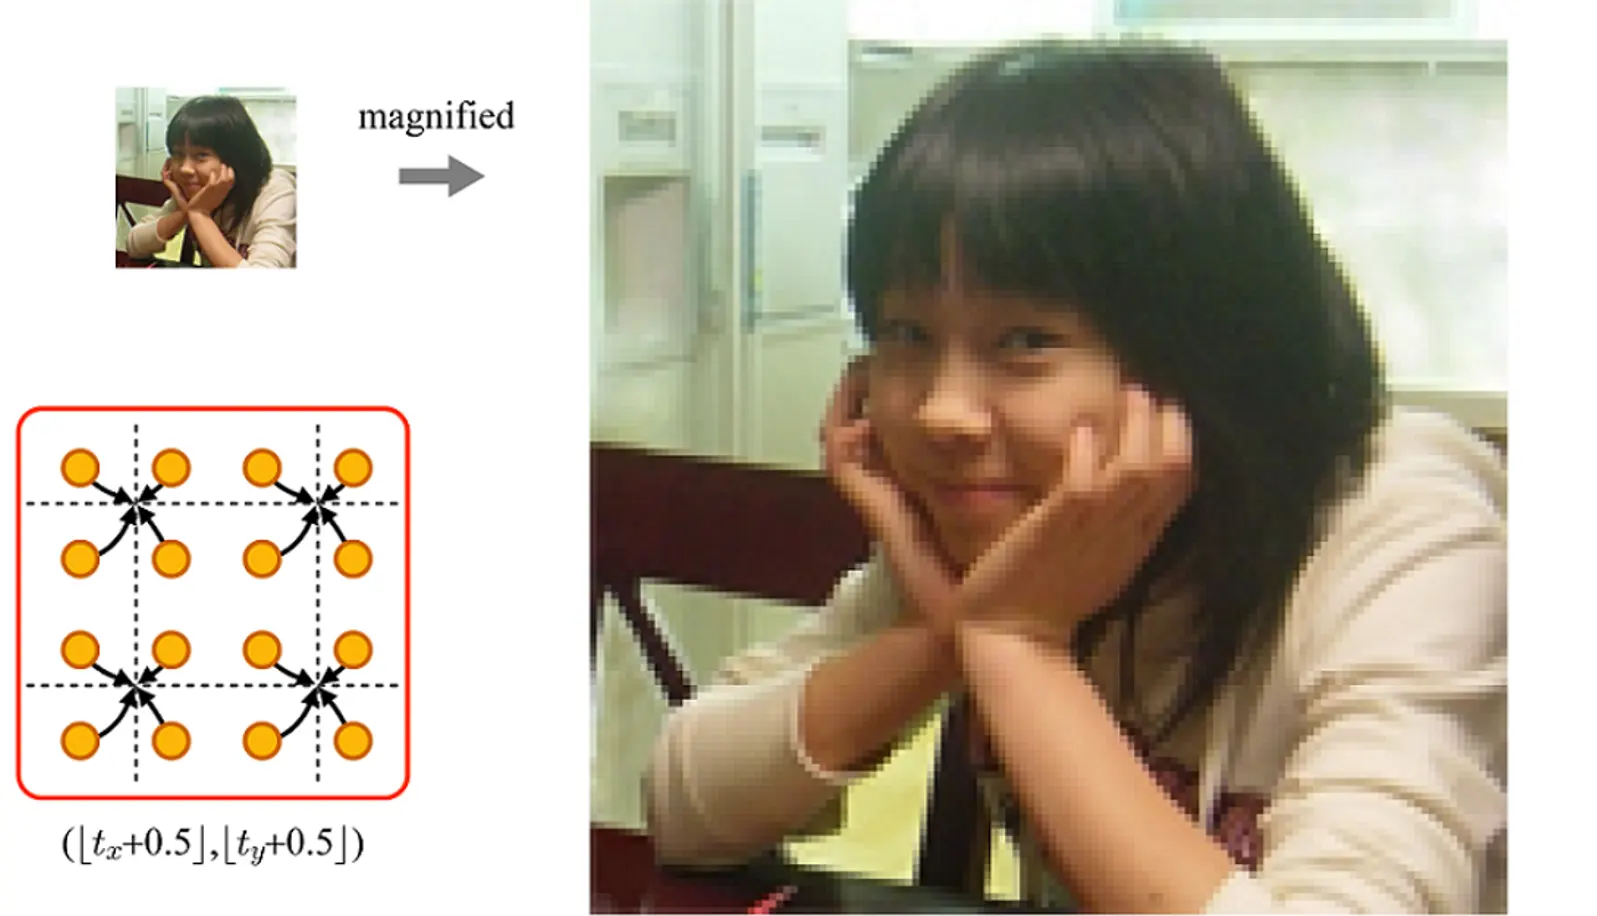
为了解决这个问题我们会使用一个采样算法,采样像素点周围四个元素,即双线性插值算法。
在一个二维矩形内,根据四个角的值求内部某个位置的值。线性插值只需要两个点,但图像是二维的。假设有四个像素: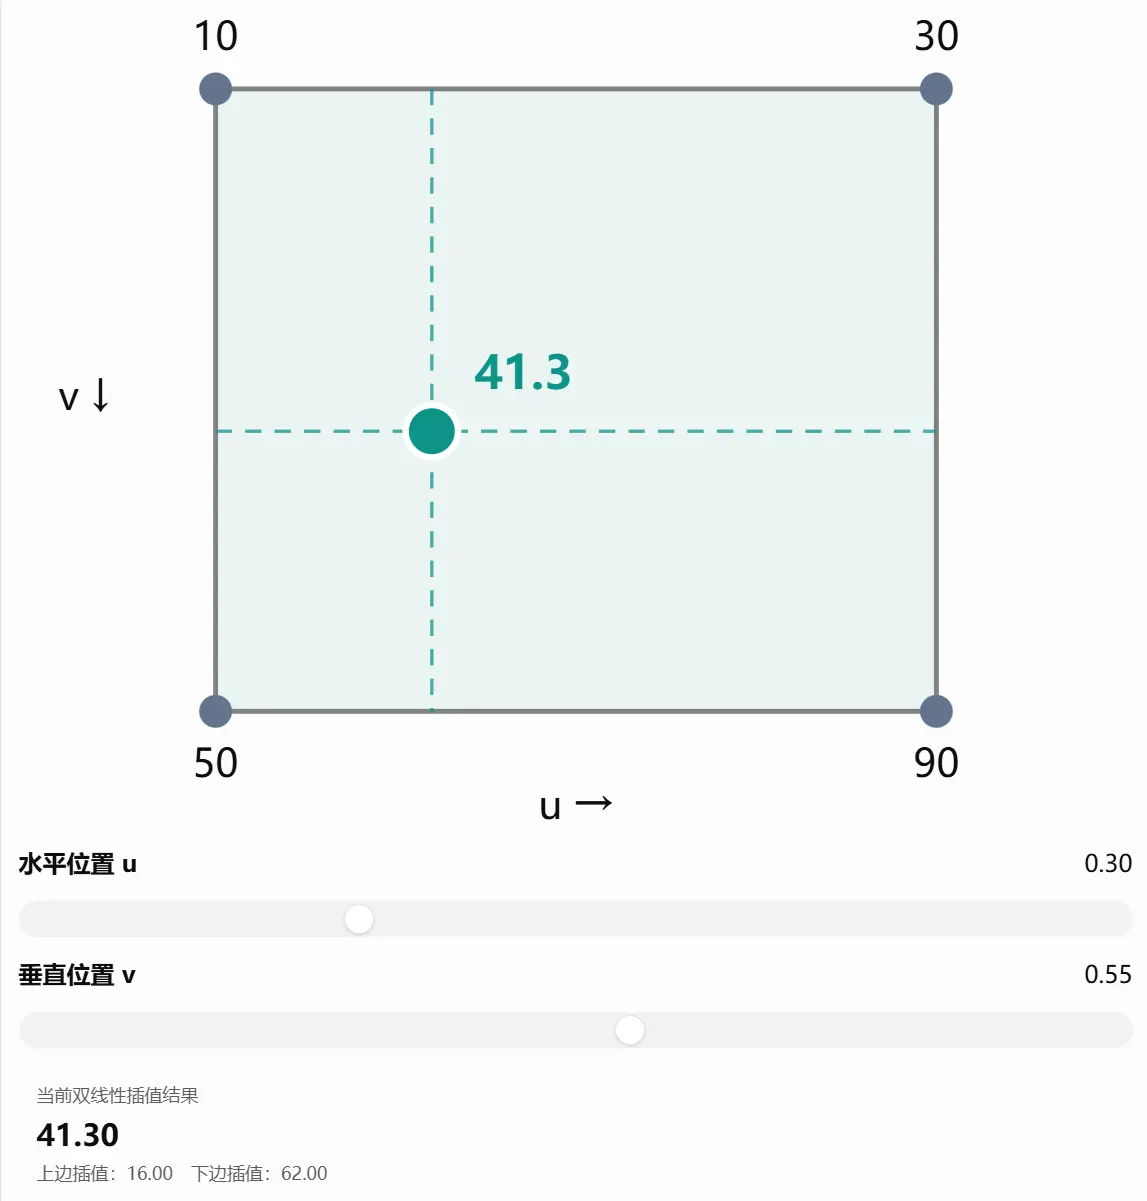
移动 u 和 v,内部采样点的结果就会变化。双线性插值并不是一种完全不同的算法。
它本质上就是三次线性插值。
第一步,沿着上边做一次线性插值:
$$
R_1=(1-u)Q_{11}+uQ_{21}
$$
第二步,沿着下边做一次线性插值:
$$
R_2=(1-u)Q_{12}+uQ_{22}
$$
第三步,在得到的两个值之间,沿垂直方向再做一次线性插值:
$$
{P=(1-v)R_1+vR_2}
$$
将前两步代入,就得到了双线性插值的完整公式:
$$
{ \begin{aligned} P={}&(1-u)(1-v)Q_{11}\\ &+u(1-v)Q_{21}\\ &+(1-u)vQ_{12}\\ &+uvQ_{22} \end{aligned} }
$$
这里 u 和 v 都在 0 到 1 之间。
四个权重相加恰好等于 1。
这个算法通常用来做最近邻采样(Nearest Neighbor)与双线性纹理过滤(Bilinear Filtering)。
unity中有对应选项:
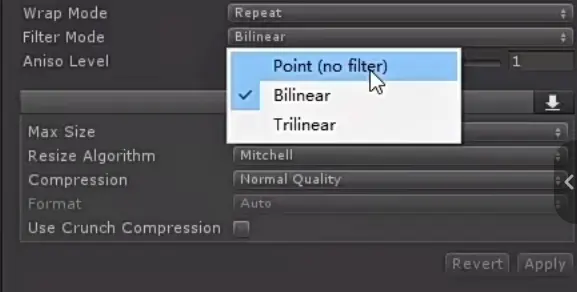
棱廓很清晰的时候可能会用point
这个机制主要是小图映射大图失真问题。
mipmap纹理链:
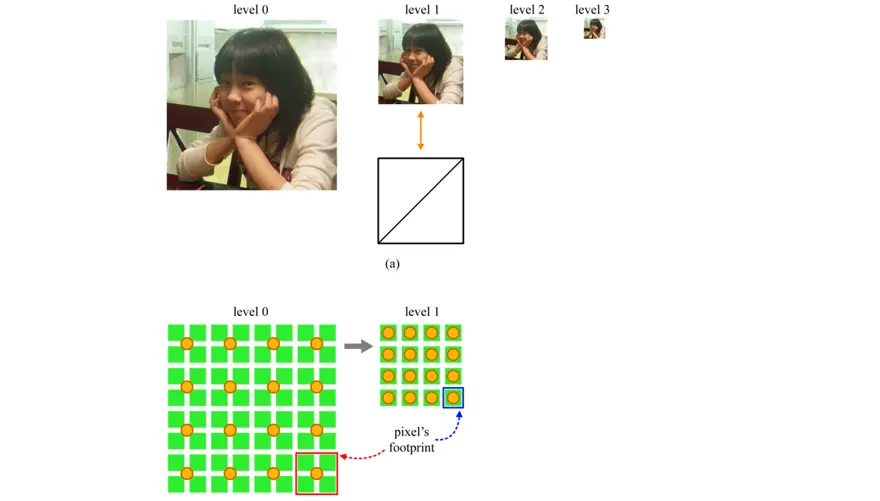
他的核心思想是:提前生成一系列分辨率逐级降低的纹理,在渲染时根据物体在屏幕上的大小,选择合适的纹理级别。
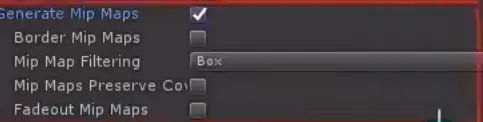
unity内目前是对应这些选项可以实现这个内容。
主要解决两个问题:纹理缩小时的走样(Aliasing) 和 纹理采样效率。
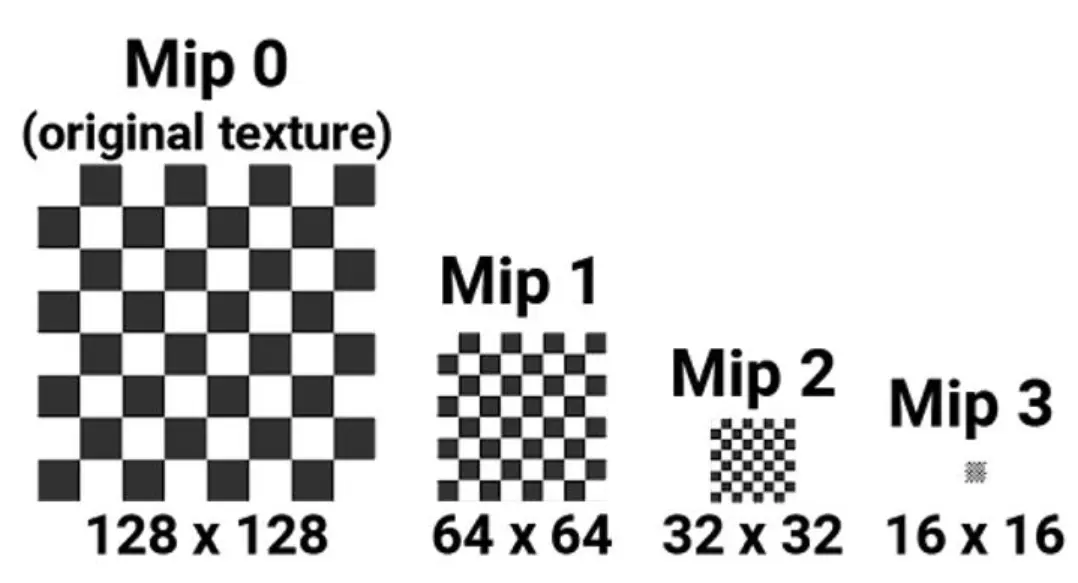
每一层的宽高都是上一层的一半:
$$
W_k=\max(1,\lfloor W_0/2^k\rfloor)
$$
$$
H_k=\max(1,\lfloor H_0/2^k\rfloor)
$$
对于 512\times512 纹理,一共有 10 层(Level 0~9)。
假设一个物体表面贴着一张高清纹理。
- 物体靠近摄像机:一个屏幕像素对应很少的纹理像素(Texel),需要高分辨率纹理。
- 物体远离摄像机:一个屏幕像素可能覆盖几十甚至几百个 Texel,需要预先过滤的低分辨率纹理。
如果始终使用原始高清纹理,远处会出现闪烁、摩尔纹、锯齿等现象。
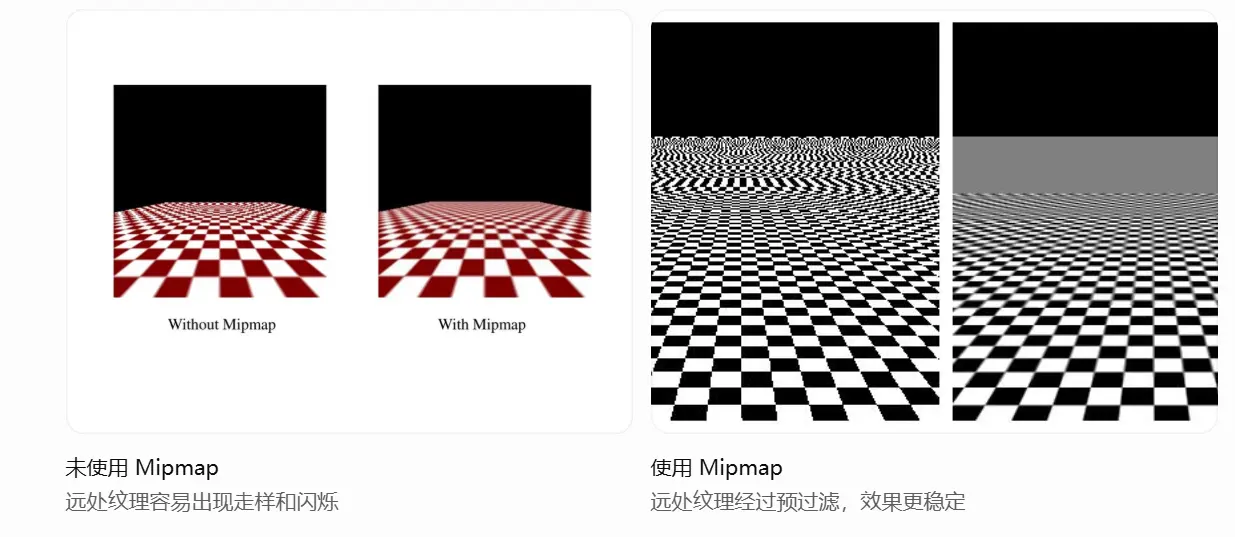
Mipmap 是怎么生成的?
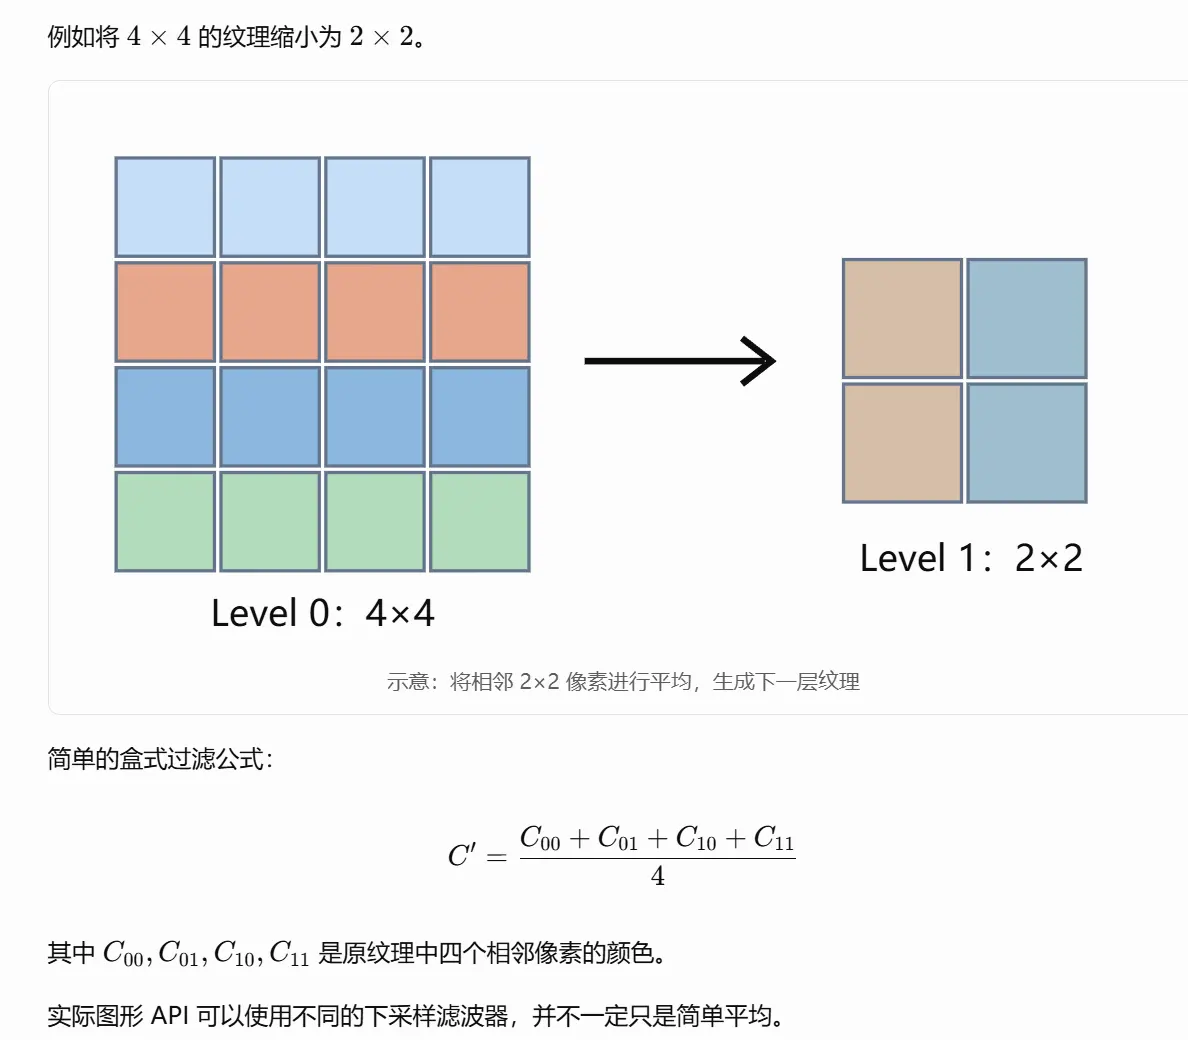
渲染时怎么选择 Mipmap 层级?
GPU 会根据纹理坐标在屏幕空间的变化率,估计一个屏幕像素覆盖多少纹理像素,进而计算 LOD(Level of Detail)。
简化理解:
$$
LOD=\log_2(\rho)
$$
其中 \rho 表示纹理采样足迹的尺度,以 Texel 为单位。
例如:
| 采样尺度 \rho | LOD | 选择层级 |
|---|---|---|
| 1 | 0 | Level 0 |
| 2 | 1 | Level 1 |
| 4 | 2 | Level 2 |
| 8 | 3 | Level 3 |
LOD 也可以是小数,例如 LOD=2.5,这时就涉及三线性过滤。
Mipmap 的内存开销
对于一张 N\times N 的纹理,完整 Mipmap 链的像素数量约为:
$$
N^2+\frac{N^2}{4}+\frac{N^2}{16}+\cdots
$$
这是一个等比数列:
$$
S=N^2\sum_{k=0}^{\infty}\left(\frac14\right)^k
$$
$$
{S\approx\frac43N^2}
$$
因此,完整 Mipmap 链比原始纹理大约多占 33.3% 的存储空间(相同像素格式下)。
纹理寻址
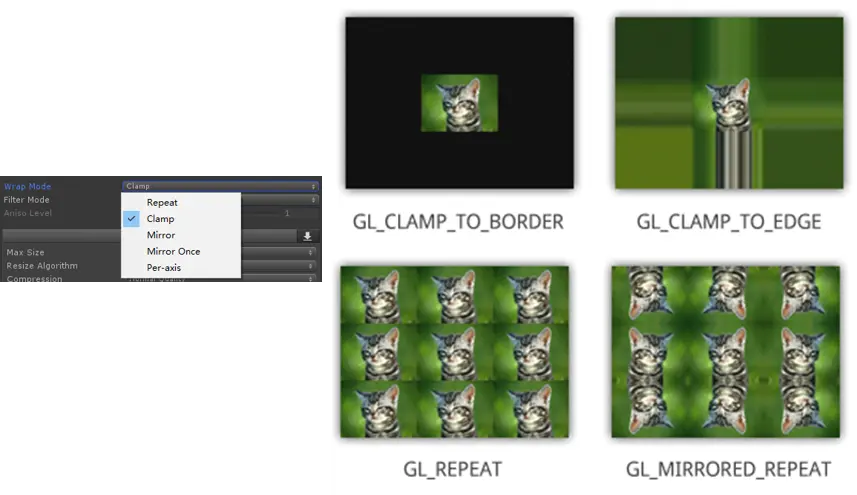
clamp不同的模式。
纹理压缩格式
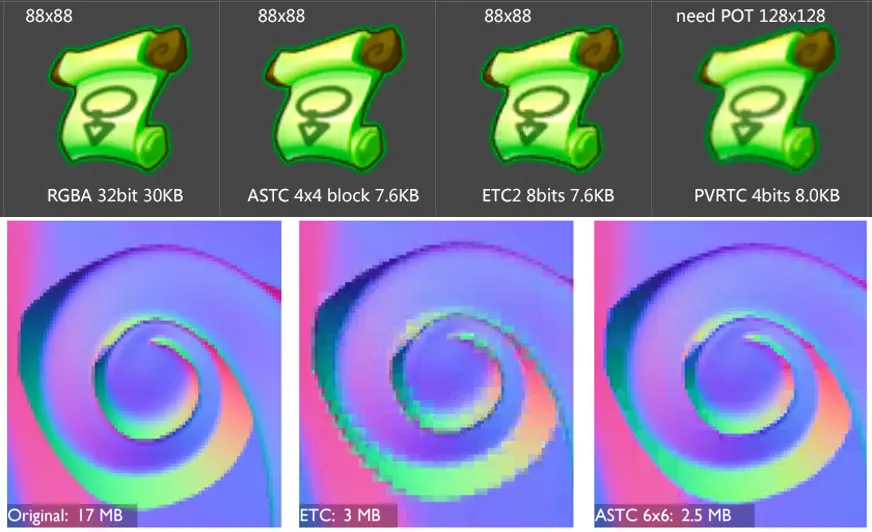
会有一些质量损失。
光照计算
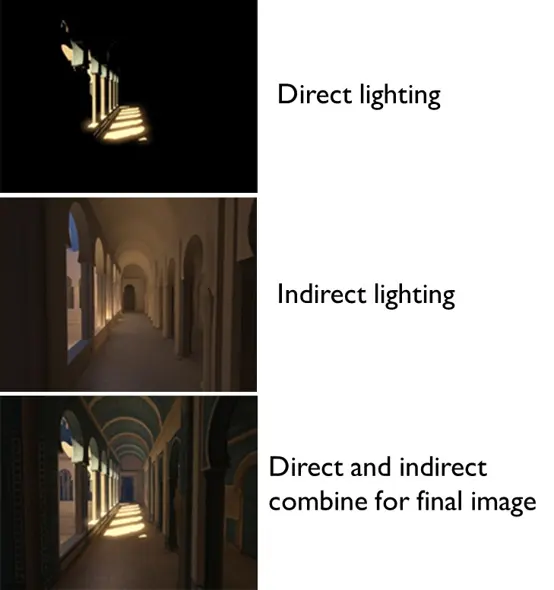
光线、反射、人眼 三要素
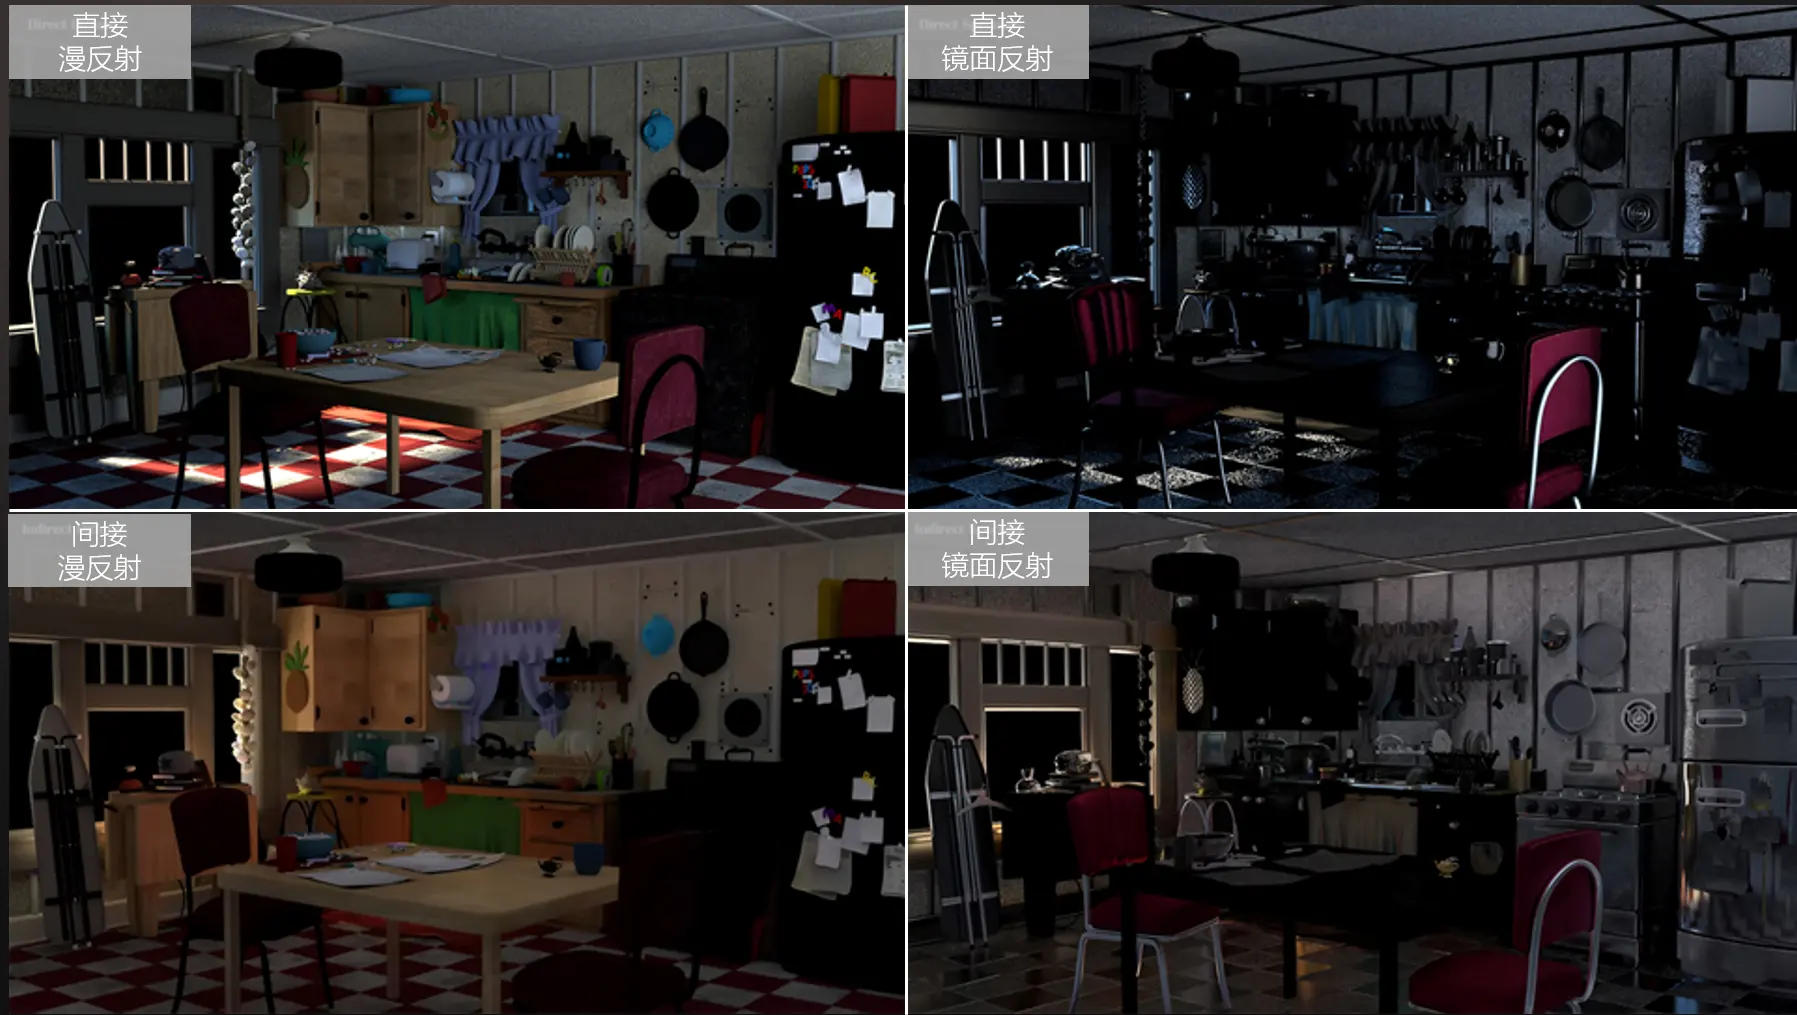
在游戏中要考虑直接光照(一次反射、为主)、间接光照(多次反射、游戏内计算非常慢)。
反射关系BRDF双向反射分布函数(复杂、无法直接用shader计算)
光照模型简化:
Phong光照模型:
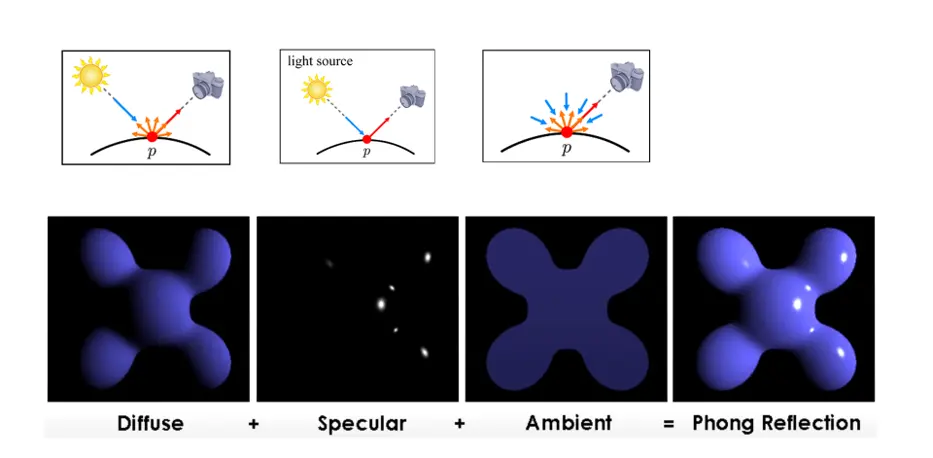
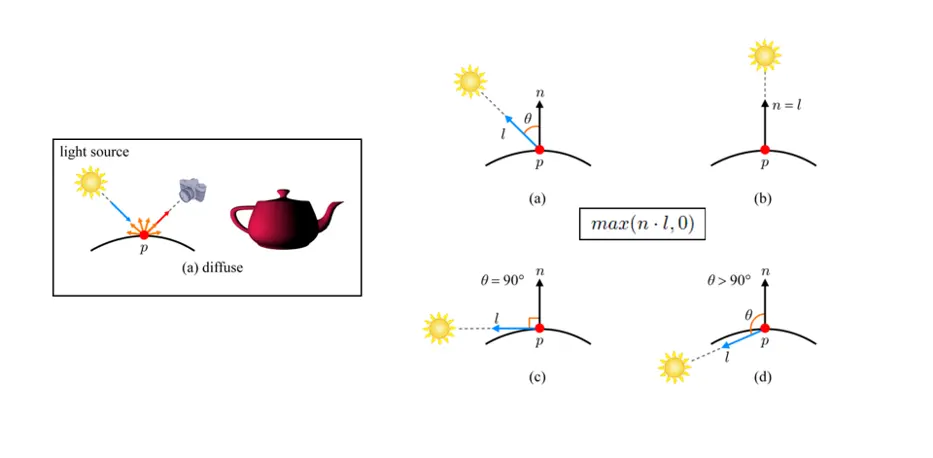
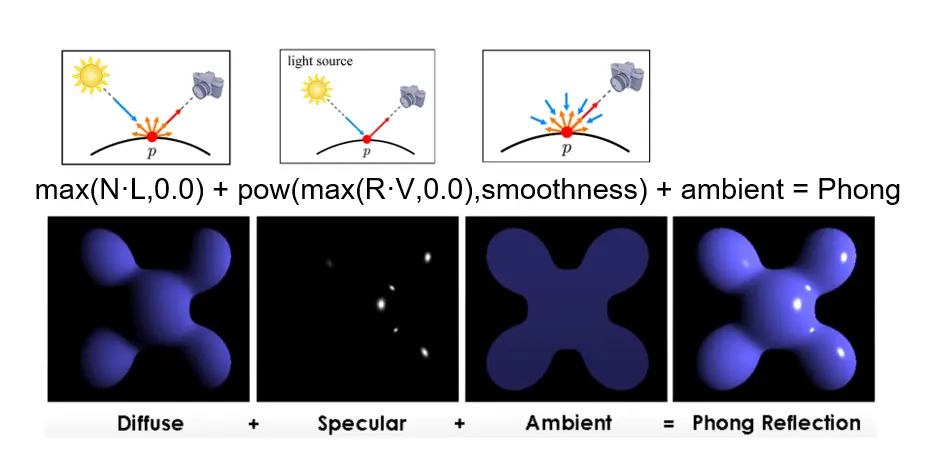
光线到达这一点后 各方向反射方向是相等的,反射强度由法向量与光线夹角决定的,夹角越小反射光强越强。>=90度后反射光强度为0。为了更方便计算,计算光线的时候,向量从点出发指向光源。从不同角度看颜色都相同。
求出向量夹角用点乘。
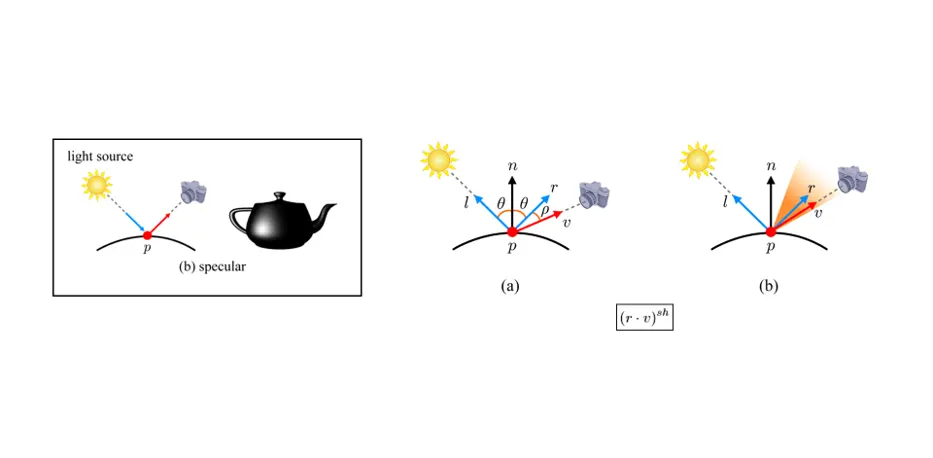
摄像机如果能恰好捕捉到反射光线的话这个点的反射强度就是最大的。
光滑度决定了衰减的范围,光滑度越大衰减范围越小。光滑度越大高光衰减范围越小,摄像机要非常接近反射光线才能观察到这个亮度。反之,同理。
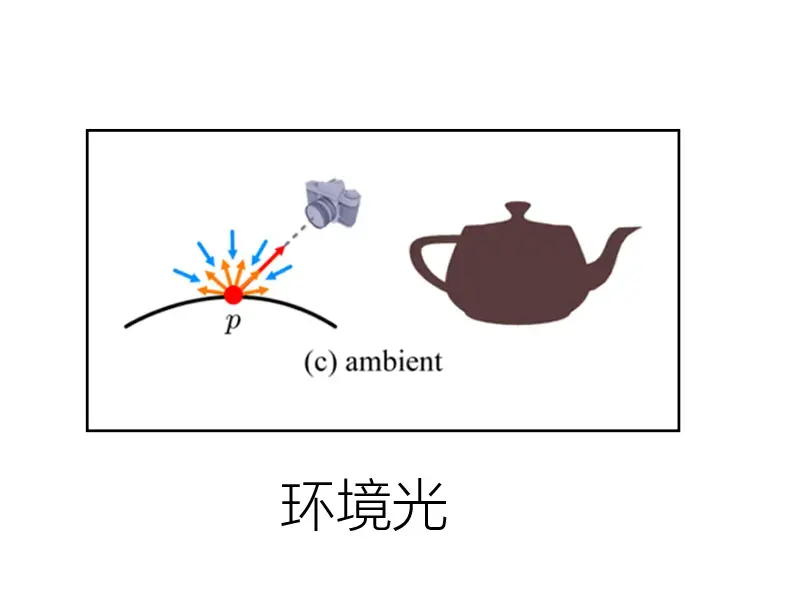
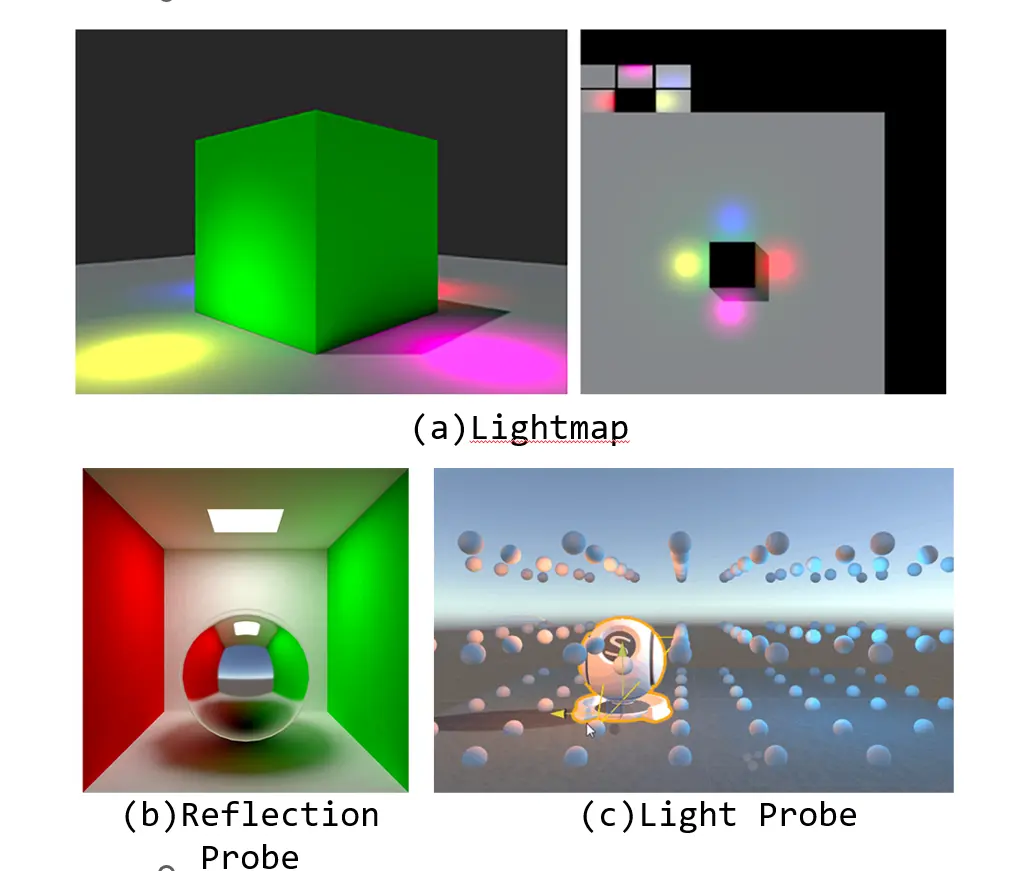
phong模型给的是纯色环境光。
环境光可以等同于间接光照。
可得这个phong光照模型
基本框架:
基本框架=直接光漫反射+ 直接光镜面反射+间接光漫反射+间接光镜面反射
输出合并
最重要的任务:处理遮挡关系、处理半透明混合
通俗地讲:片元通过重重考验到达像素点位置的过程。
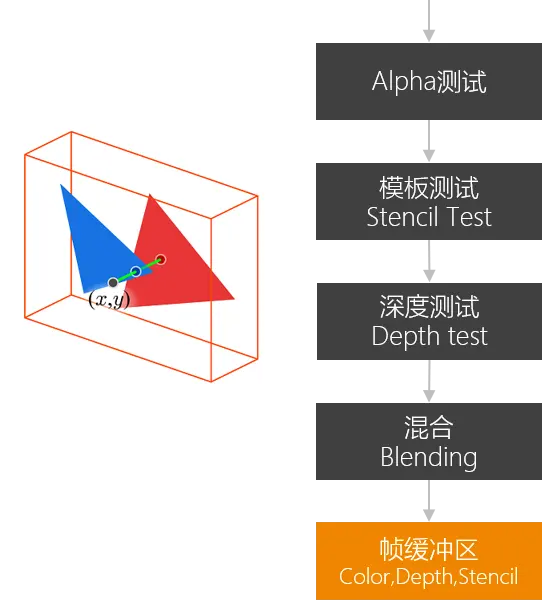
Alpha如果低于一定的值会直接丢弃。
深度测试
(x,y)有两个重叠片元进行竞争,如何确定谁在前面,谁的深度越小谁越靠前。
混合计算后输出到帧缓冲区,临时的画板。
帧缓冲区
- 颜色缓冲区 Color Buffer
- 深度缓冲区 Depth Buffer
- 模板缓冲区 Stencil Buffer假设我们要首先渲染红色的三角形,片元深度是0.8,深度测试的时候,要比较当前的片元对比缓冲区的深度值,如果比缓冲区内深度值要小就能通过深度测试,通过后就可以覆盖掉原来的缓冲区的数值,同时color buffer也会进行覆写。当我们再去生成蓝的时候也是遵循这个竞争机制,谁的数值小谁可以覆盖该片元。
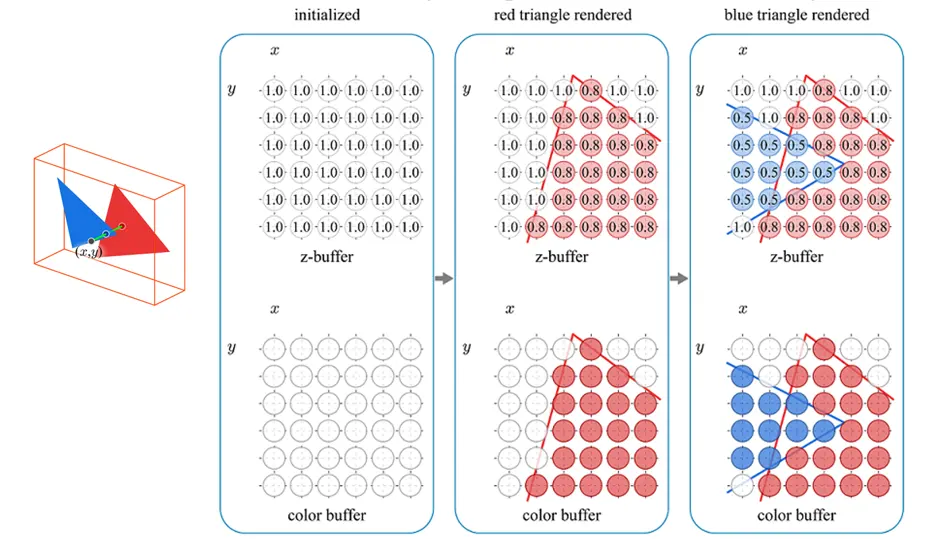 假设我们要首先渲染红色的三角形,片元深度是0.8,深度测试的时候,要比较当前的片元对比缓冲区的深度值,如果比缓冲区内深度值要小就能通过深度测试,通过后就可以覆盖掉原来的缓冲区的数值,同时color buffer也会进行覆写。当我们再去生成蓝的时候也是遵循这个竞争机制,谁的数值小谁可以覆盖该片元。
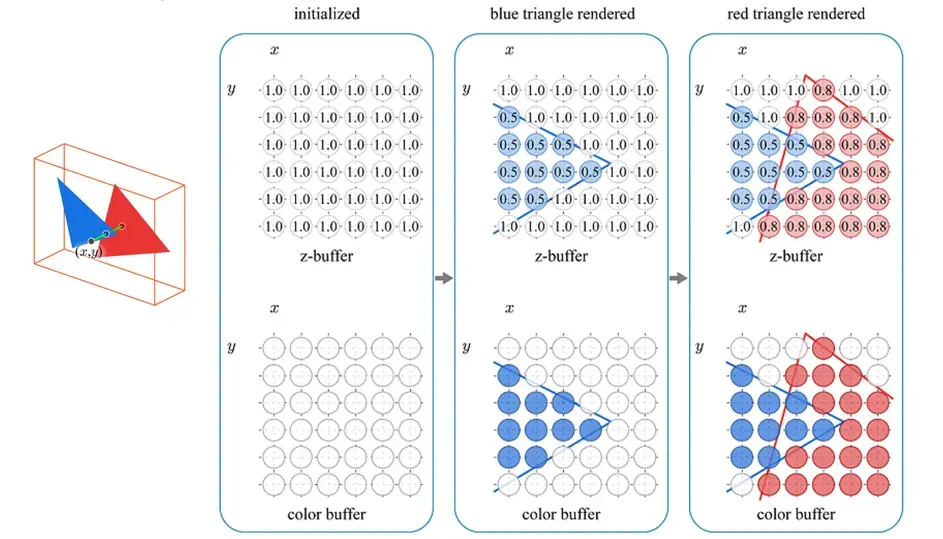
如果先渲染蓝色也是同理 如上图。
深度测试
ZWrite深度写入:即便通过也不会覆写深度缓冲区,深度写入机制并不会影响颜色缓冲区正常覆写,深度缓冲区不会更新。
ZTest深度测试:shader内自定义覆写。
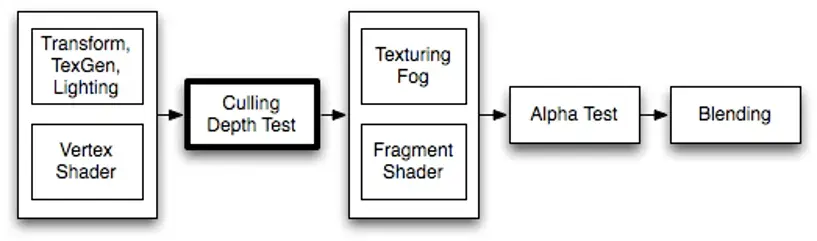
Early-Z测试提前深度测试,为了更好的优化。光栅化后就明确知道深度值了,可以直接进行剔除,遮挡的部分直接干掉。节省计算开销。和硬件支持有关。
模板测试
通过模板缓冲区(Stencil Buffer)中的数值,控制哪些片元允许被渲染,哪些片元应该被丢弃。
模板缓冲区通常为每个像素位置存储一个 8 位整数,取值范围为 0~255。
渲染时,GPU 会比较:
$$
(S \ \&\ M)\ \text{CompareOp}\ (R\ \&\ M)
$$
其中:
- S:模板缓冲区当前存储的值。
- R:参考值(Reference Value)。
- M:读取掩码(Read Mask)。
- CompareOp:比较操作,例如 Equal、Less、Always。
例如,设置参考值为 1,比较操作为 Equal,就可以只允许模板值等于 1 的片元通过。
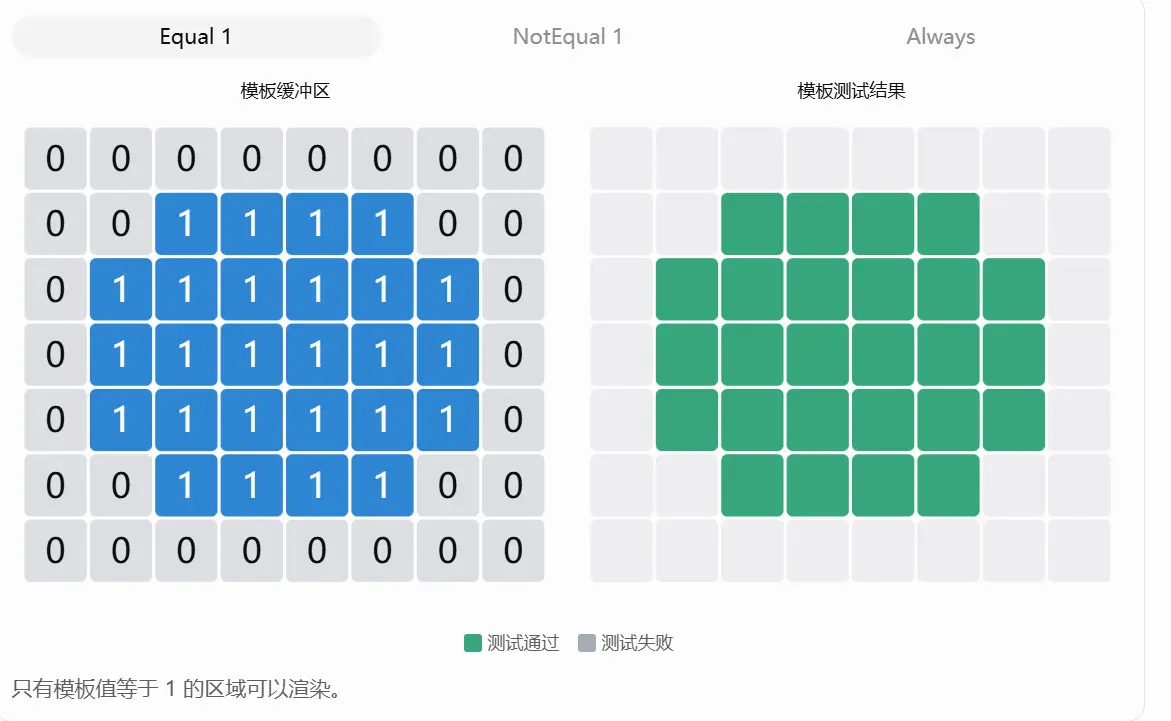
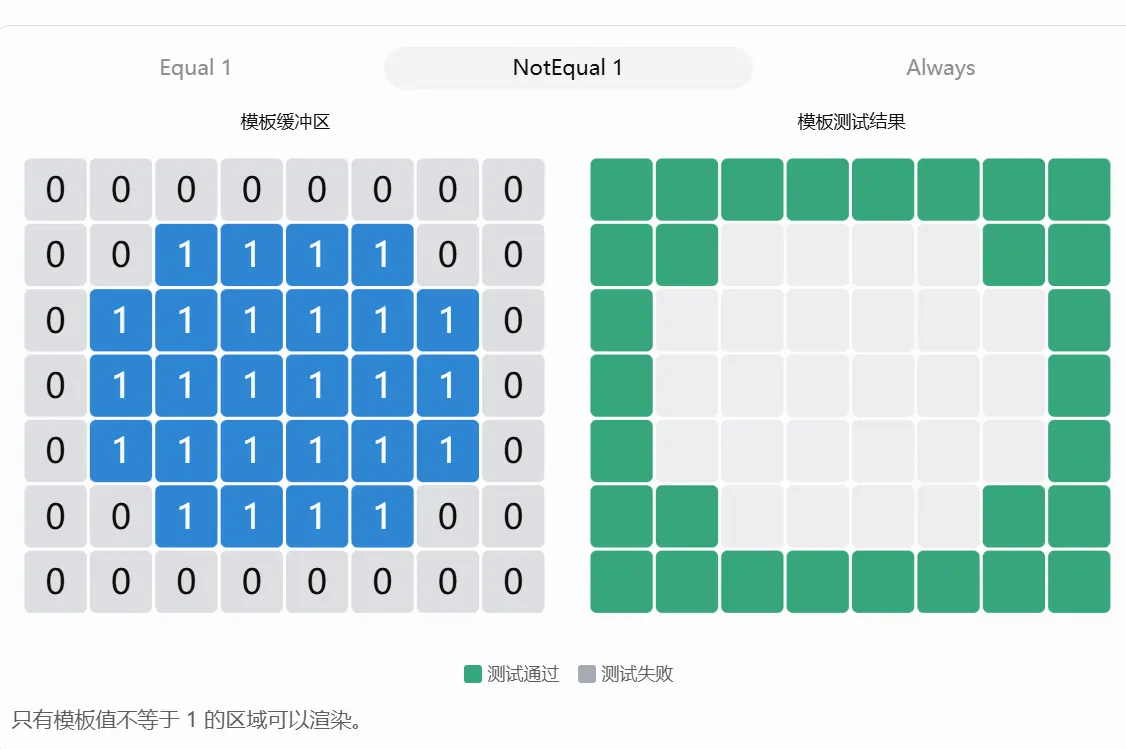
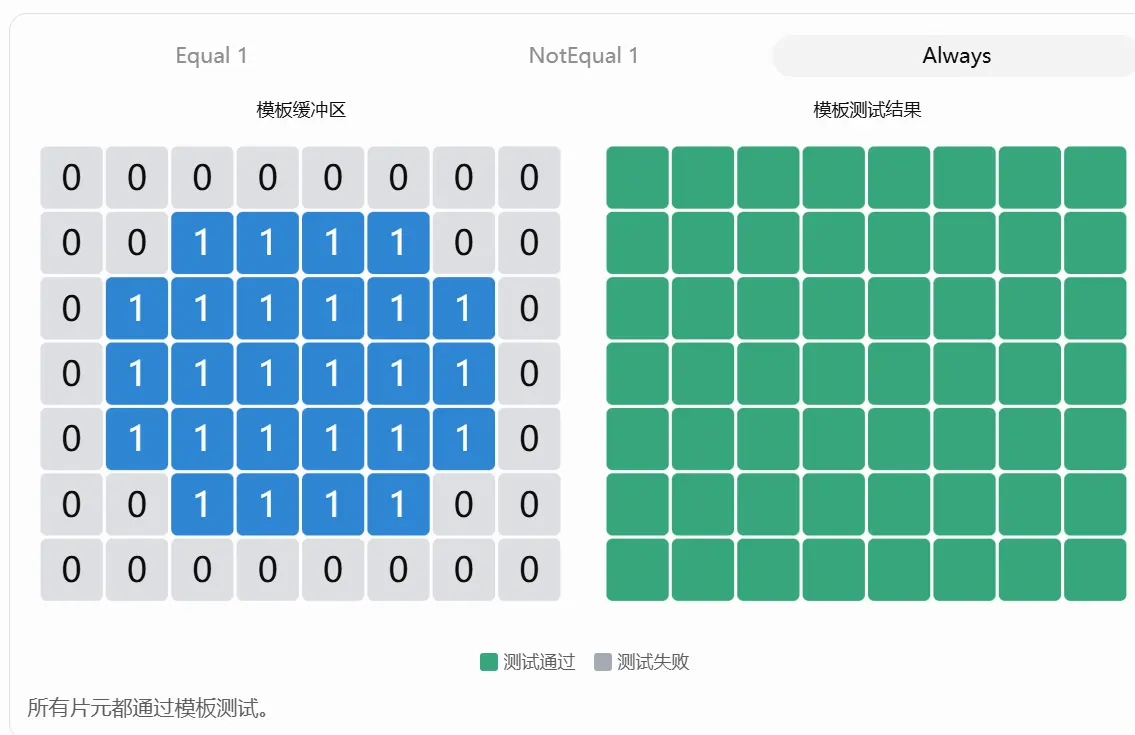
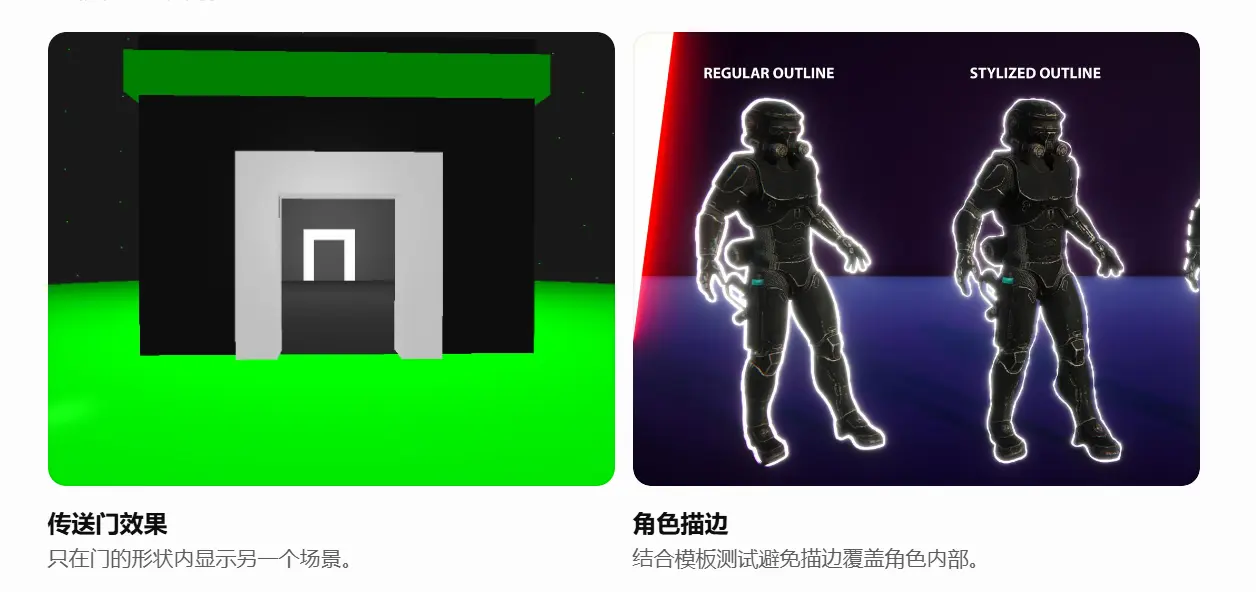
用来控制渲染区域,深度测试用来控制物体遮挡关系。
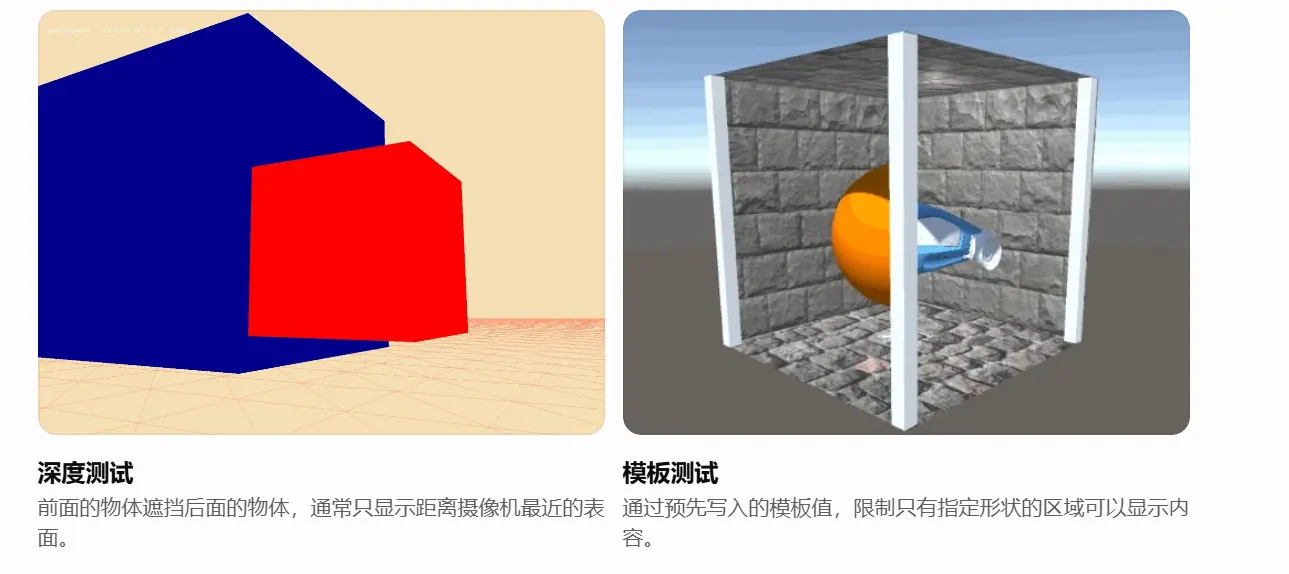
深度测试关心的是距离。模板测试不关心物体远近,只关心模板值是否满足设定的比较条件。
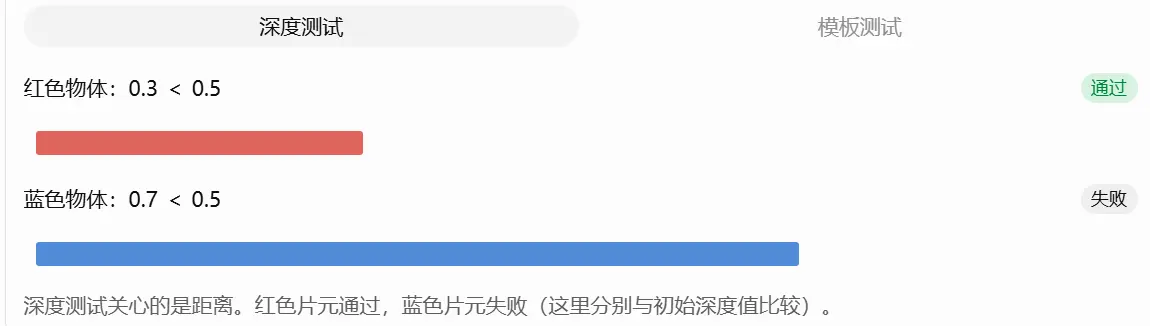
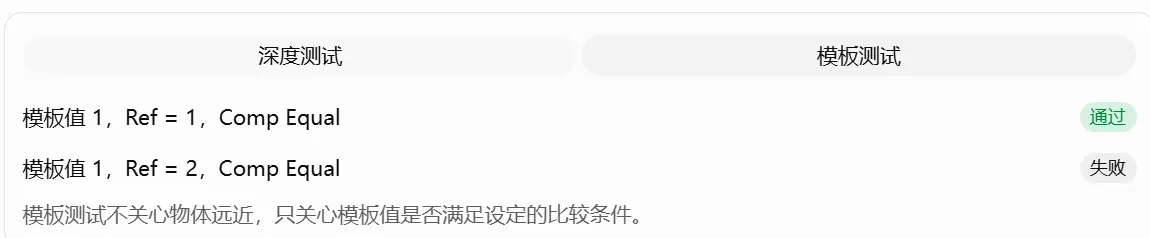
| 对比项目 | 深度测试 | 模板测试 |
|---|---|---|
| 缓冲区 | Z-Buffer | Stencil Buffer |
| 存储内容 | 深度值 | 整数模板值 |
| 比较依据 | 片元深度与已有深度 | 模板值与参考值 |
| 主要作用 | 解决遮挡关系 | 控制渲染区域 |
| 典型用途 | 隐藏面消除 | 遮罩、描边、传送门 |
| 是否需要预先写入 | 通常由渲染过程写入深度 | 通常需要先建立模板区域 |
混合(blending)
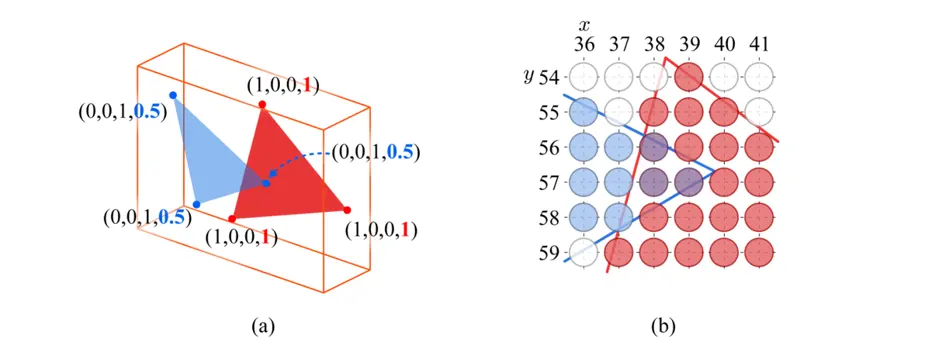
渲染片元时会拿到当前片元的颜色值,对比缓冲区同位置color的颜色值,两个值混合计算,得到新颜色值,对缓冲区元位置进行覆写。
半透明混合效果:
$$
Alpha Blend = SrcColor * SrcAlpha + DestColor * (1.0 – SrcAlpha)
$$
SrcColor 片元颜色值,DestColor对应缓冲区位置的颜色值
Blend SrcAlpha OneMinusSrcAlpha 使用这个写入shader进行控制。
半透明混合要主要从后到前!!!很难能保证顺序,无法避免。一般需要关闭ZWrite写入
整体流程图